
Chunking, Indexing và Retrieval trong RAG: Hướng Dẫn Cho Người Mới Bắt Đầu
RAG (Retrieval-Augmented Generation) là giải pháp hàng đầu giúp mô hình AI trả lời chính xác dựa trên dữ liệu riêng mà không cần tốn kém chi phí tái huấn luyện. Tuy nhiên, việc tối ưu hóa quy trình từ khâu chunking, chọn mô hình embedding cho đến bảo mật dữ liệu trước prompt injection đòi hỏi một cách tiếp cận bài bản. Bài viết này sẽ phân tích trọn vẹn quy trình 6 bước, so sánh RAG với Fine-tuning và cung cấp bộ ba tiêu chí (RAG Triad) để đánh giá chất lượng hệ thống chuẩn xác nhất.
Mục lục bài viết
1. RAG là gì? Hiểu đơn giản trong 2 phút2. Quy trình 6 bước của một hệ thống RAG3. Không có mô hình Embedding "tốt nhất" cho mọi dự án4. Chunking: "Nghệ thuật" chia nhỏ văn bản5. RAG hay Fine-tuning: Khi nào dùng cái nào?6. Bảo mật trong RAG: Đừng bỏ qua rủi ro Prompt Injection7. Bộ ba đánh giá chất lượng RAG (RAG Triad)
1. RAG là gì? Hiểu đơn giản trong 2 phút
Bạn từng hỏi ChatGPT một câu về tài liệu nội bộ công ty và nhận được câu trả lời… bịa? Đó là vì AI không hề biết dữ liệu riêng của bạn. RAG (Retrieval-Augmented Generation) ra đời để giải quyết đúng vấn đề này: thay vì chỉ dựa vào kiến thức có sẵn trong mô hình, RAG sẽ truy xuất thông tin từ kho tài liệu của bạn rồi mới trả lời.
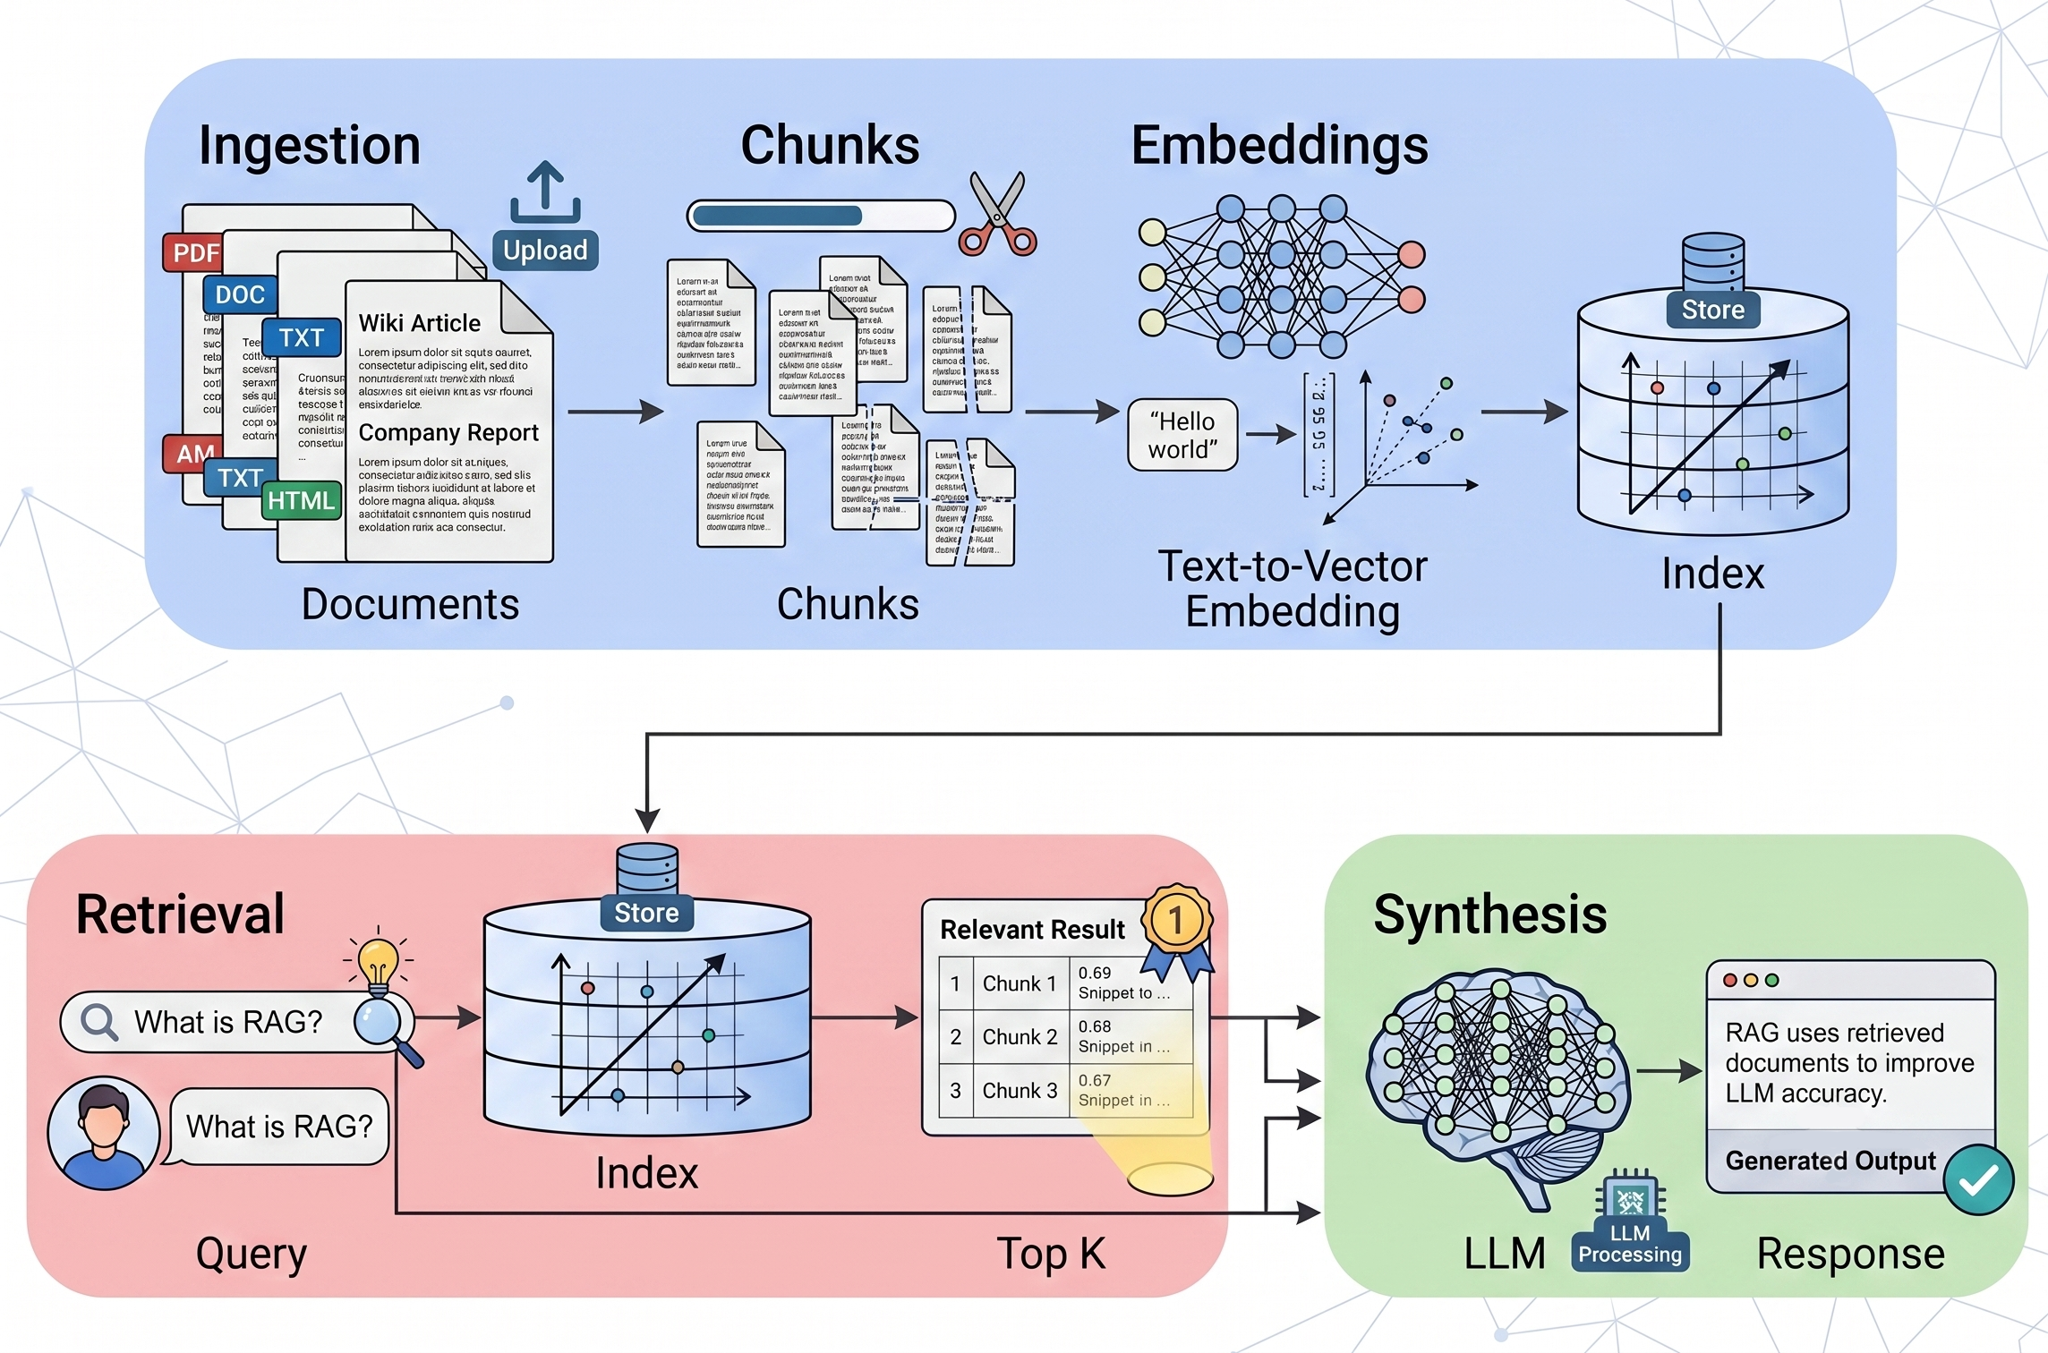
Quy trình của RAG
Nói cách khác, RAG kết hợp hai loại "bộ nhớ": bộ nhớ tham số (kiến thức được huấn luyện sẵn trong LLM) và bộ nhớ phi tham số (kho tài liệu bên ngoài mà bạn cung cấp). Kết quả là câu trả lời vừa chính xác, vừa có nguồn trích dẫn rõ ràng.
2. Quy trình 6 bước của một hệ thống RAG
Để RAG hoạt động trơn tru, dữ liệu của bạn phải trải qua một chuỗi xử lý gồm 6 bước:
Nạp dữ liệu (Ingest): Thu thập tài liệu từ nguồn nội bộ — file PDF, tài liệu Word, trang web nội bộ, hoặc bất kỳ nguồn thông tin nào bạn muốn AI "học".
Phân mảnh (Chunking): Văn bản thô được chia thành những đoạn nhỏ (chunks) vừa đủ để tìm kiếm. Đây là bước cực kỳ quan trọng — chia quá to thì tốn token và chậm, chia quá nhỏ thì mất ngữ cảnh.
Nhúng toán học (Embedding): Mỗi đoạn văn bản được chuyển thành một vector số — một dạng "tọa độ" trong không gian ngữ nghĩa. Những đoạn có ý nghĩa gần nhau sẽ nằm gần nhau trong không gian này.
Lập chỉ mục (Indexing): Toàn bộ vector được sắp xếp vào cơ sở dữ liệu tối ưu cho tìm kiếm (như Azure AI Search), sẵn sàng để truy vấn nhanh.
Truy xuất (Retrieval): Khi bạn đặt câu hỏi, hệ thống tìm những đoạn văn bản liên quan nhất trong chỉ mục để làm "dữ liệu nền" cho AI.
Sinh phản hồi (Generation): LLM nhận câu hỏi của bạn cùng dữ liệu nền vừa truy xuất được, rồi đưa ra câu trả lời kèm nguồn tham chiếu cụ thể.
3. Không có mô hình Embedding "tốt nhất" cho mọi dự án
Nhiều người mới bắt đầu thường hỏi: "Mô hình embedding nào tốt nhất cho RAG?" Câu trả lời thực tế là: không có một mô hình nào luôn đứng đầu trong mọi tình huống. Việc chọn mô hình nhúng phụ thuộc vào chính dự án của bạn, cân nhắc trên ba yếu tố chính:
Độ trễ và chi phí: Mô hình nhúng càng lớn thì càng tốn tài nguyên tính toán. Khi người dùng gửi câu hỏi, hệ thống phải tính vector nhúng theo thời gian thực — mô hình nặng đồng nghĩa với phản hồi chậm hơn và chi phí token cao hơn.
Tương thích với chỉ mục: Không phải mô hình nào cũng hoạt động tốt với mọi kiểu tìm kiếm. Bạn cần đảm bảo mô hình nhúng tương thích với cấu hình tìm kiếm của mình — dù là vector thuần túy hay hybrid (kết hợp từ khóa + vector).
Ngôn ngữ và lĩnh vực: Không có con số benchmark cố định nào áp dụng được cho mọi ngôn ngữ hay mọi ngành nghề. Cách tốt nhất là tự thử nghiệm và đánh giá trên chính dữ liệu thực tế của doanh nghiệp bạn.
4. Chunking: "Nghệ thuật" chia nhỏ văn bản
Kích thước mảnh (chunk size) và độ chồng lặp (overlap) là hai thông số ảnh hưởng trực tiếp đến chất lượng truy xuất. Không có con số "vàng" nào phù hợp cho tất cả — mỗi dự án cần tự hiệu chỉnh dựa trên đặc điểm tài liệu và mức độ rủi ro chấp nhận được.
Nguyên tắc chung: chunk quá lớn dễ gây vượt giới hạn token và tăng chi phí; chunk quá nhỏ làm mất ngữ cảnh liền mạch, khiến AI trả lời thiếu chính xác. Ngoài ra, đừng quên đính kèm metadata (tiêu đề, URL, tên file) vào chỉ mục — đây là "chìa khóa" để câu trả lời có nguồn trích dẫn chất lượng.
5. RAG hay Fine-tuning: Khi nào dùng cái nào?
Đây là câu hỏi phổ biến với người mới. Dưới đây là so sánh nhanh giúp bạn quyết định:
Tốc độ cập nhật: RAG cho phép tích hợp tài liệu mới chỉ trong vài phút. Fine-tuning tốn hàng giờ đến hàng ngày để huấn luyện lại — không phù hợp với dữ liệu thay đổi thường xuyên.
Nguồn dẫn chứng: RAG cung cấp nguồn tham chiếu trực tiếp cho từng câu trả lời. Mô hình fine-tuned không thể làm được điều này.
Độ chính xác: RAG giảm thiểu rủi ro "ảo giác" (bịa đặt) nhờ bám sát dữ liệu ngữ cảnh. Fine-tuning phù hợp hơn để dạy AI văn phong, giọng điệu hoặc định dạng nghiệp vụ.
Tin vui là bạn không nhất thiết phải chọn một trong hai: hoàn toàn có thể kết hợp cả RAG và fine-tuning trên cùng một mô hình — tinh chỉnh để AI học phong cách trước, rồi dùng RAG để liên tục cấp tri thức mới.
6. Bảo mật trong RAG: Đừng bỏ qua rủi ro Prompt Injection
Một rủi ro ít được nhắc đến với người mới là Prompt Injection gián tiếp. Kẻ xấu có thể nhúng câu lệnh độc hại vào tài liệu trong kho dữ liệu của bạn. Khi AI truy xuất trúng đoạn đó, nội dung độc hại có thể ép mô hình thực hiện hành động ngoài ý muốn — từ rò rỉ thông tin đến thực thi lệnh trái phép.
Điều quan trọng cần nhớ: cả RAG lẫn fine-tuning đều không tự động loại bỏ lỗ hổng prompt injection. Để an toàn, bạn cần áp dụng các biện pháp kiểm soát như:
- Phân quyền cấp tài liệu (document-level access control) ngay từ khâu truy xuất
- Sử dụng phân quyền dựa trên vai trò (RBAC) thay vì API key tĩnh trong môi trường vận hành
- Áp dụng nguyên tắc phân quyền tối thiểu cho các tác vụ nhạy cảm — luôn có bước phê duyệt của con người với những hành động không thể đảo ngược
7. Bộ ba đánh giá chất lượng RAG (RAG Triad)
Làm sao biết hệ thống RAG của bạn đang hoạt động tốt? Hãy kiểm tra theo ba tiêu chí sau:
Sự liên quan ngữ cảnh: Dữ liệu truy xuất được có thực sự khớp với câu hỏi của người dùng không?
Tính xác thực trên ngữ cảnh: Câu trả lời có hoàn toàn dựa trên dữ liệu đã truy xuất, hay AI đang tự "bịa" thêm?
Sự phù hợp phản hồi: Câu trả lời cuối cùng có giải quyết đúng và đầy đủ yêu cầu ban đầu không?
Tổng kết
Xây dựng hệ thống RAG hiệu quả không đơn giản là chọn mô hình embedding "mạnh nhất". Đó là cả một quy trình tinh chỉnh đồng bộ từ chunking, indexing, retrieval cho đến generation — và quan trọng không kém là các lớp bảo mật đi kèm. Hãy bắt đầu với dữ liệu của chính bạn, thử nghiệm các cấu hình khác nhau, và luôn giữ một "human-in-the-loop" cho những quyết định quan trọng.
Xem thêm tại GearVN
