
Embedding là gì? Cách vector embedding hoạt động trong RAG
Vector embedding là nền tảng giúp hệ thống RAG truy xuất đúng ngữ cảnh, nhưng một kết quả tìm kiếm tốt chưa chắc đảm bảo câu trả lời hoàn hảo. Bài viết này sẽ giải mã cơ chế hoạt động, chỉ ra những giới hạn cốt lõi của embedding và cung cấp checklist thực tế giúp technical builder tối ưu hệ thống RAG.
Mục lục bài viết
1. Embedding là gì trong một hệ thống RAG?2. Vector embedding hoạt động thế nào?3. Vì sao retrieval tốt không đồng nghĩa câu trả lời tốt?4. Embedding trong RAG: những giới hạn không nên bỏ qua5. Checklist triển khai cho technical builder
1. Embedding là gì trong một hệ thống RAG?
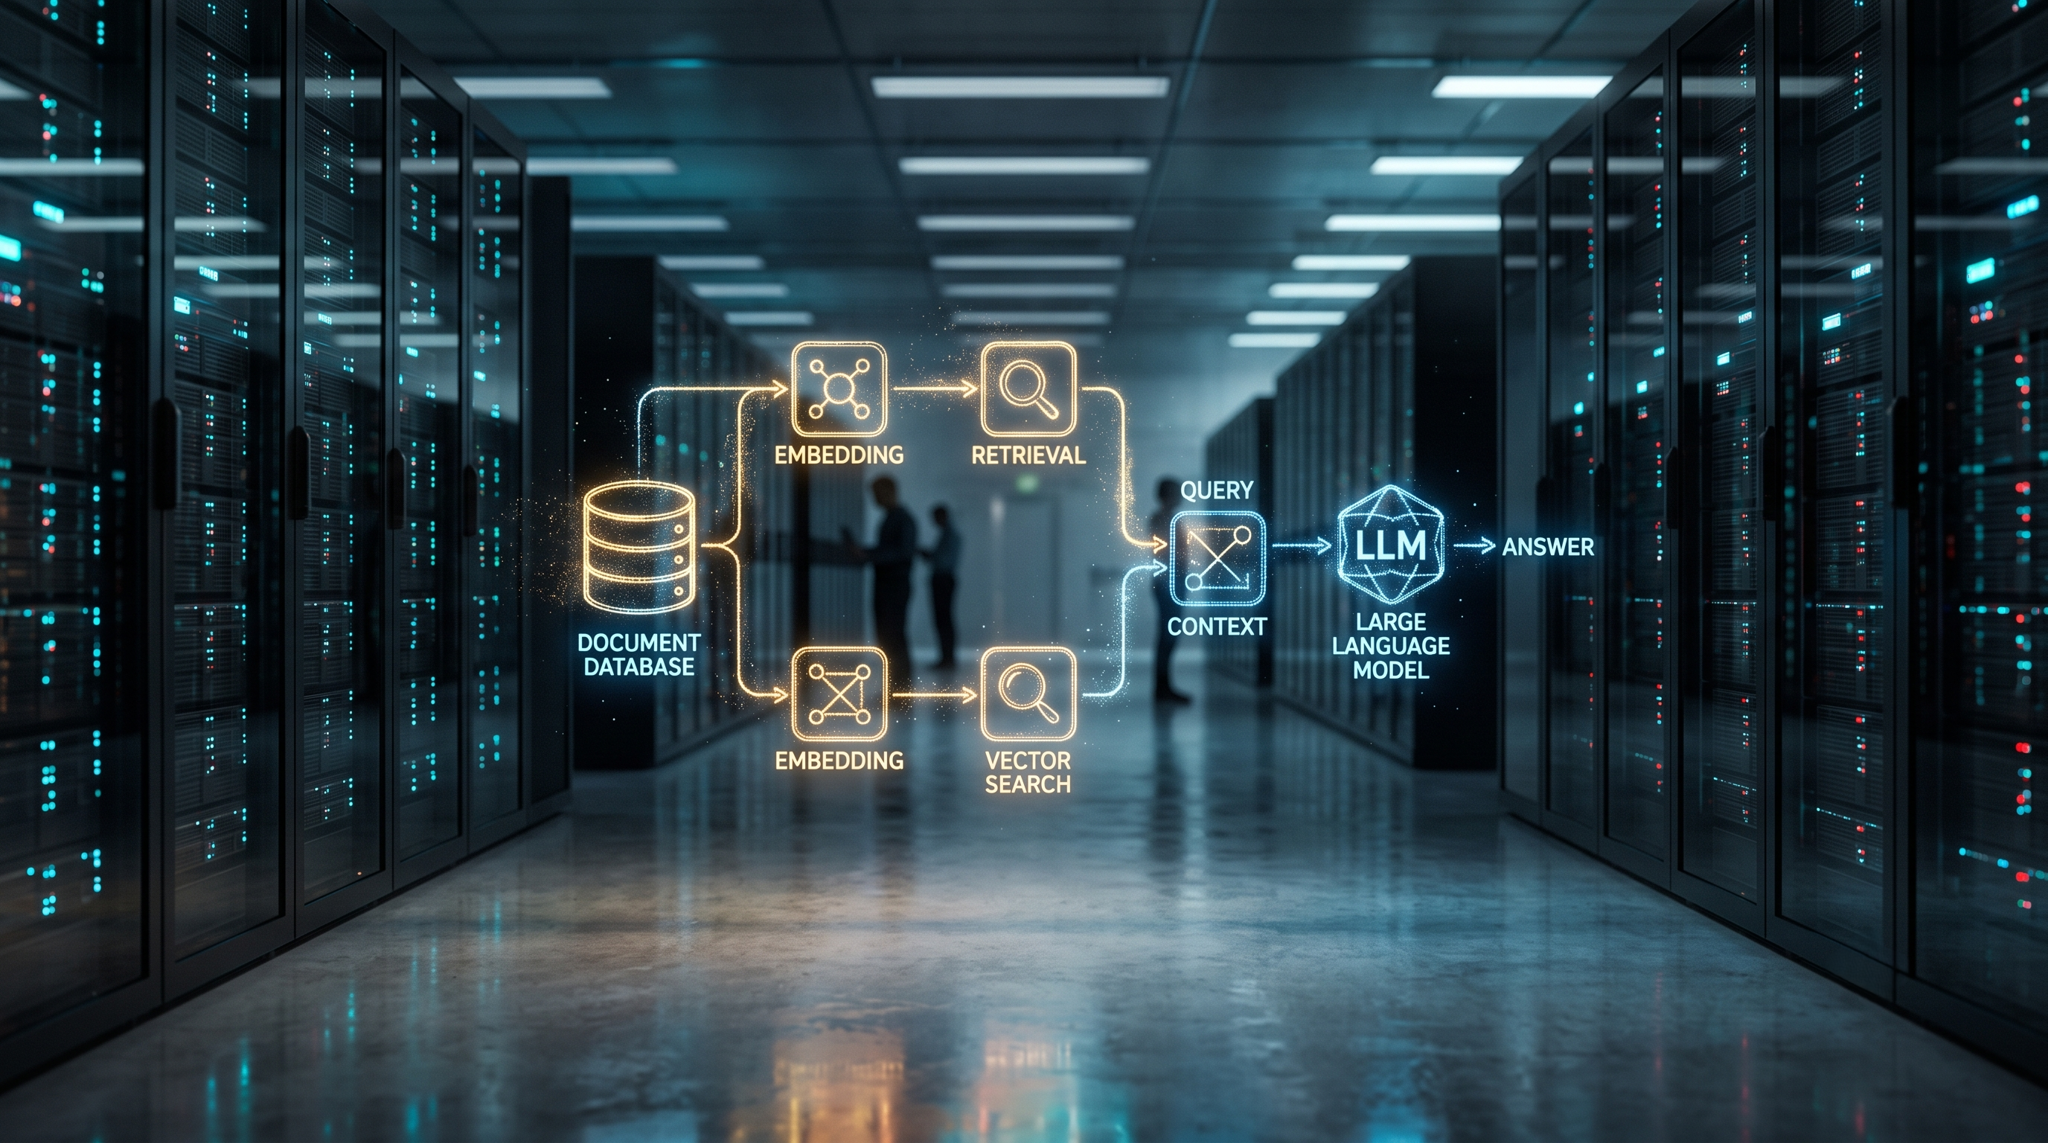
Embedding là cách biểu diễn nội dung thành vector để hệ thống có thể so sánh mức độ liên quan về ngữ nghĩa. Trong RAG, tài liệu không được đưa nguyên khối vào model: hệ thống thường chia tài liệu thành các đoạn, gắn metadata, tạo chỉ mục văn bản và vector, rồi truy xuất những đoạn phù hợp khi có câu hỏi.
Nếu mới làm quen với kiến trúc này, bạn có thể xem phần giải thích về RAG là gì và ba bước retrieve, augment, generate.
Embedding là một phần của bước retrieval, không phải cơ chế huấn luyện lại model và cũng không tự bảo đảm câu trả lời luôn đúng.
Embedding giúp tìm context phù hợp hơn, nhưng chất lượng đầu ra vẫn phụ thuộc vào dữ liệu, chỉ mục, truy vấn và cách đánh giá.
2. Vector embedding hoạt động thế nào?
Ở giai đoạn ingest, tài liệu được phân tích cấu trúc rồi chia thành chunk theo giới hạn của model và ngữ cảnh tài liệu. Mỗi chunk có thể đi kèm metadata như nguồn, loại tài liệu hoặc quyền truy cập. Sau đó, hệ thống tạo index để phục vụ tìm kiếm lexical, vector hoặc hybrid.
- Chuẩn bị tài liệu: xác định nguồn có thẩm quyền, cấu trúc và metadata cần giữ lại.
- Chunking: chia thành các đơn vị đủ nghĩa để retrieve; chunk quá nhỏ có thể mất ngữ cảnh, còn chunk quá lớn có thể gây nhiễu và tốn context.
- Lập chỉ mục: lưu text/vector cùng metadata và ACL phù hợp.
- Truy xuất: câu hỏi tạo candidate qua keyword, vector hoặc hybrid search; filter và reranking chọn context trước khi model sinh câu trả lời.
Không có một kích thước chunk hay top-k chung cho mọi corpus. Quy tắc hợp lý là bắt đầu từ cấu trúc tài liệu và giới hạn model, sau đó kiểm chứng bằng bộ câu hỏi thật thay vì sao chép một cấu hình mặc định.
3. Vì sao retrieval tốt không đồng nghĩa câu trả lời tốt?
Retrieval và câu trả lời cuối là hai lớp cần đánh giá riêng. Một đoạn có độ tương đồng cao chưa chắc trả lời đúng ý định truy vấn; ngược lại, model có thể diễn giải vượt quá context đã lấy được. Vì vậy, nên chuẩn bị query có expected document hoặc locator, đo khả năng lấy đúng tài liệu và review các lỗi theo nhóm tài liệu.
| Lớp cần kiểm tra | Câu hỏi thực hành |
| Retrieval | Top-k có chứa đúng tài liệu hoặc locator mong đợi không? |
| Xếp hạng | Reranking có ưu tiên đoạn liên quan hơn không? |
| Câu trả lời | Nội dung có grounded, liên quan và đầy đủ theo context không? |
Các tín hiệu như recall, NDCG hoặc fidelity có thể hữu ích khi có ground truth; tuy nhiên ngưỡng đạt không nên được áp cố định cho mọi ứng dụng. Bộ dữ liệu, mức độ rủi ro và hậu quả khi trả lời sai quyết định cách hiệu chỉnh.
4. Embedding trong RAG: những giới hạn không nên bỏ qua
Vector search không luôn tốt hơn lexical hoặc hybrid search. Từ khóa chính xác, thuật ngữ nội bộ và cấu trúc tài liệu có thể khiến một chiến lược đơn lẻ bỏ sót context quan trọng. Thử nghiệm lexical, vector và hybrid trên query set thật sẽ đáng tin cậy hơn việc mặc định chọn một phương án.
RAG có thể giúp grounding câu trả lời, nhưng không loại bỏ hoàn toàn hallucination hoặc prompt injection.
Retrieved content và dữ liệu từ tool cần được xem là dữ liệu không đáng tin cậy. Guardrails nên được triển khai nhiều lớp, gồm kiểm soát input, nội dung truy xuất, phân quyền tool, output, monitoring và human intervention cho hành động rủi ro cao. Model từ chối một yêu cầu không thay thế cho authorization.
5. Checklist triển khai cho technical builder
Xác định nguồn dữ liệu, authority và quyền truy cập trước khi index.
Chọn quy tắc chunking theo cấu trúc tài liệu, chỉ dùng overlap khi cần.
Lưu metadata và ACL để filter retrieval đúng phạm vi.
Tạo bộ query có expected locator để kiểm thử retrieval.
Đánh giá riêng retrieval, citation và groundedness của câu trả lời.
Theo dõi lỗi, refresh index và chạy regression khi tài liệu thay đổi.
Việc chọn cấu hình vẫn nên dựa trên workload, mô hình và quy mô dữ liệu dự kiến.
Khi cần chuẩn bị môi trường chạy thử cho workload AI, có thể tham khảo danh mục AI PC tại GEARVN để xác định lựa chọn phần cứng phù hợp với nhu cầu thực tế.
Kết luận
Hiểu embedding là gì giúp bạn nhìn đúng vai trò của vector trong RAG: hỗ trợ tìm context, không thay thế đánh giá hay kiểm soát bảo mật. Hãy bắt đầu từ dữ liệu và query set thật, đo retrieval trước, rồi mới tối ưu câu trả lời của chatbot.
