
Hybrid RAG là gì? Kết hợp Local AI và Cloud AI cho dữ liệu nội bộ
Hybrid RAG là kiến trúc giữ dữ liệu và bước truy xuất quan trọng tại chỗ, đồng thời cho phép chọn model local hoặc cloud ở bước suy luận. Cách làm này phù hợp với trợ lý tài liệu doanh nghiệp vì vừa kiểm soát dữ liệu, vừa có đường mở rộng cho câu hỏi khó hoặc tải tăng đột biến.
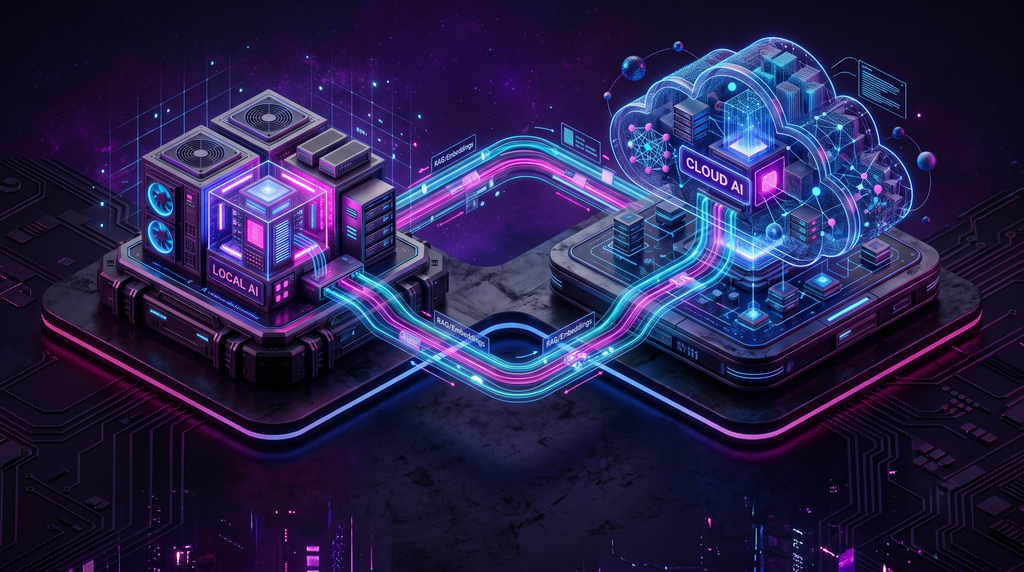
Trong Hybrid RAG, router quyết định dữ liệu nào được giữ local và khi nào cần gọi model cloud.
1. RAG giải quyết vấn đề gì?
Retrieval-Augmented Generation (RAG) bổ sung ngữ cảnh được tìm từ nguồn dữ liệu kiểm soát trước khi model tạo câu trả lời. Thay vì mong model nhớ chính sách nội bộ, hệ thống tìm các đoạn liên quan từ tài liệu rồi yêu cầu model trả lời dựa trên những đoạn đó.
RAG không tự động bảo đảm câu trả lời đúng. Chất lượng phụ thuộc vào dữ liệu nguồn, cách chia đoạn, embedding, metadata, bộ truy xuất, reranker, prompt và model sinh câu trả lời. Hệ thống cũng cần hiển thị trích dẫn để người dùng kiểm tra.
2. Vì sao gọi là Hybrid RAG?
Tài liệu NVIDIA AI Workbench gọi dự án là “hybrid” vì inference có thể chạy trên máy local, NVIDIA inference endpoint hoặc NIM microservice. Trong triển khai doanh nghiệp, khái niệm này nên được mở rộng thành chính sách rõ ràng cho từng tầng của pipeline.
- Tài liệu gốc, chỉ mục và quyền truy cập nằm trong mạng nội bộ.
- Embedding và retrieval chạy local để dữ liệu thô không phải rời hệ thống.
- Model local xử lý câu hỏi thông thường.
- Model cloud chỉ nhận phần ngữ cảnh đã lọc khi câu hỏi vượt ngưỡng độ khó hoặc hệ thống local quá tải.
- Log ghi lại route, nguồn trích dẫn và phiên bản model nhưng không lưu secret hoặc dữ liệu nhạy cảm ngoài chính sách.
3. Kiến trúc Hybrid RAG gồm bảy bước
- Nạp dữ liệu: lấy tài liệu từ nguồn được phê duyệt, lưu chủ sở hữu, phiên bản và quyền truy cập.
- Tiền xử lý: OCR nếu cần, làm sạch, chia đoạn và gắn metadata.
- Tạo embedding: biến đoạn tài liệu thành vector bằng model được cố định phiên bản.
- Truy xuất và rerank: tìm các đoạn liên quan rồi sắp xếp lại bằng model reranker.
- Policy router: đánh giá độ nhạy dữ liệu, độ khó, tải và ngân sách để chọn local hoặc cloud.
- Sinh câu trả lời: yêu cầu model chỉ dùng ngữ cảnh được cấp, kèm liên kết hoặc ID nguồn.
- Đánh giá và quan sát: lưu chỉ số chất lượng, độ trễ, route và phản hồi người dùng.
4. Router nên quyết định bằng tiêu chí nào?
| Tín hiệu | Chạy local | Chuyển Cloud có kiểm soát |
| Độ nhạy dữ liệu | Có dữ liệu cá nhân, bí mật hoặc tài liệu hạn chế | Chỉ khi ngữ cảnh đã được loại/redact theo chính sách |
| Độ khó | FAQ, trích xuất và tóm tắt ngắn | Reasoning nhiều bước hoặc ngữ cảnh rất dài |
| Tải hệ thống | Còn trong ngưỡng concurrency local | Hàng đợi vượt SLA đã định |
| Chất lượng retrieval | Nguồn rõ, điểm liên quan đủ cao | Không nên gửi cloud nếu không có nguồn; cần hỏi lại người dùng |
| Ngân sách | Tác vụ lặp lại khối lượng lớn | Ca khó có giá trị cao và giới hạn chi phí |
Cloud không thể sửa retrieval kém. Nếu các đoạn tìm được không liên quan, router nên trả về yêu cầu làm rõ hoặc chuyển người phụ trách thay vì dùng model lớn để đoán.
Ví dụ: Trợ lý kiến thức cho đội bán hàng
Giả sử đội bán hàng cần hỏi về tính năng sản phẩm, quy trình bảo hành và chính sách nội bộ. Catalog công khai có thể được cập nhật thường xuyên; tài liệu chính sách chỉ dành cho nhân viên; dữ liệu khách hàng phải được bảo vệ.
Pipeline local xác thực người dùng, lọc tài liệu theo quyền và tìm các đoạn liên quan. Câu hỏi thông thường được model local trả lời kèm nguồn. Khi cần tổng hợp nhiều tài liệu dài, router tạo một gói ngữ cảnh đã bỏ dữ liệu khách hàng rồi mới gọi endpoint cloud được phê duyệt. Câu trả lời vẫn phải trích nguồn và không được tự thực hiện thao tác đặt hàng.
Ví dụ: Tìm kiếm và tóm tắt video nội bộ
Video đào tạo hoặc cuộc họp có thể được tách âm thanh, nhận dạng lời nói và tạo embedding tại workstation. Người dùng tìm đúng mốc thời gian trước; chỉ đoạn video hoặc transcript liên quan mới đi vào model. Cách này giảm lượng dữ liệu phải truyền và giúp kiểm soát nơi lưu media gốc.
5. Chọn model và hạ tầng cho Hybrid RAG
Pipeline RAG nên chọn riêng model embedding, reranking, generation và safety. Model lớn nhất không nhất thiết làm retrieval tốt hơn. Hãy benchmark recall của retrieval, độ chính xác rerank và groundedness của câu trả lời như ba lớp độc lập.
NVIDIA NIM cung cấp các microservice model với API nhất quán cho hạ tầng NVIDIA. Tài liệu NIM cũng hỗ trợ chọn profile theo GPU, VRAM và yêu cầu song song. Với local, cần tính cả context và concurrency; với cloud, cần tính giới hạn tốc độ, vùng dữ liệu và chi phí.
Để thử nghiệm trên thiết bị tại chỗ, có thể bắt đầu từ nhóm AI PC GEARVN. Pipeline video, mô hình lớn hoặc nhiều người dùng có thể cần workstation GPU cho tác vụ chuyên sâu. Hãy đối chiếu yêu cầu model trước khi mua, không chọn chỉ theo tên dòng máy.
Checklist bảo mật và vận hành:
- Phân quyền tại bước retrieval, không chỉ ở giao diện chatbot.
- Mã hóa dữ liệu lưu trữ và đường truyền; tách secret khỏi prompt và log.
- Redact dữ liệu trước khi route ra ngoài; ghi lý do và policy version.
- Giới hạn nguồn mà model được phép trích dẫn.
- Đặt ngưỡng từ chối khi không tìm thấy bằng chứng phù hợp.
- Pin phiên bản model, embedding và index để có thể tái hiện kết quả.
- Chạy bộ câu hỏi đánh giá sau mỗi lần đổi model hoặc dữ liệu.
- Có kill switch và đường fallback khi cloud hoặc local gặp sự cố.
Lộ trình pilot thực tế
Tuần 1: Chọn một kho tài liệu, làm sạch quyền truy cập và tạo 50 câu hỏi chuẩn.
Tuần 2: Dựng bản local end-to-end, đo retrieval và groundedness.
Tuần 3: Thêm cloud fallback cho nhóm câu hỏi khó đã xác định.
Tuần 4: Kiểm thử bảo mật, giới hạn chi phí và chạy thử với nhóm người dùng nhỏ.
Chỉ mở rộng khi pilot chứng minh được ba điều: trả lời dựa trên nguồn, dữ liệu đi đúng policy và chi phí mỗi tác vụ nằm trong ngưỡng.
Nguồn tham khảo chính thức từ NVIDIA:
Nội dung được GEARVN tổng hợp và diễn giải từ tài liệu chính thức NVIDIA, cập nhật ngày 15/07/2026. Kiến trúc mẫu cần được điều chỉnh theo chính sách dữ liệu và workload của từng tổ chức.
