
Model size, quantization và context trong Local AI — Hiểu đúng để chọn mô hình phù hợp
Local AI đang trở thành xu hướng hàng đầu cho những ai muốn tự chủ hoàn toàn dữ liệu và tối ưu chi phí vận hành mà không phụ thuộc vào đám mây. Để bắt đầu hiệu quả, việc hiểu rõ mối liên kết giữa ba thành phần cốt lõi cùng các lưu ý phần cứng là bước đi then chốt. Bài viết này sẽ giải mã toàn diện bức tranh Local AI và mang đến lộ trình tiếp cận dễ dàng nhất cho người mới bắt đầu.
Mục lục bài viết1. Local AI là gì và tại sao cần quan tâm?2. Ba "nhân vật chính" trong Local AI3. Mối quan hệ giữa ba yếu tố4. Những điều cần lưu ý khi bắt đầu5. Gợi ý cho người mới bắt đầu
1. Local AI là gì và tại sao cần quan tâm?
Local AI (Trí tuệ nhân tạo cục bộ) là việc chạy các mô hình AI ngay trên máy tính của bạn, thay vì gửi dữ liệu lên đám mây. Hướng tiếp cận này đang ngày càng phổ biến với doanh nghiệp nhờ khả năng kiểm soát dữ liệu tại nguồn và giảm phụ thuộc vào dịch vụ đám mây.
Tuy nhiên, cần hiểu rõ: "local" chỉ mô tả vị trí thực thi các tác vụ suy luận (inference) — nơi mô hình "suy nghĩ" và đưa ra câu trả lời. Nó không đồng nghĩa với việc hệ thống hoàn toàn không cần mạng, miễn phí vận hành, hay bảo mật tuyệt đối.
2. Ba "nhân vật chính" trong Local AI
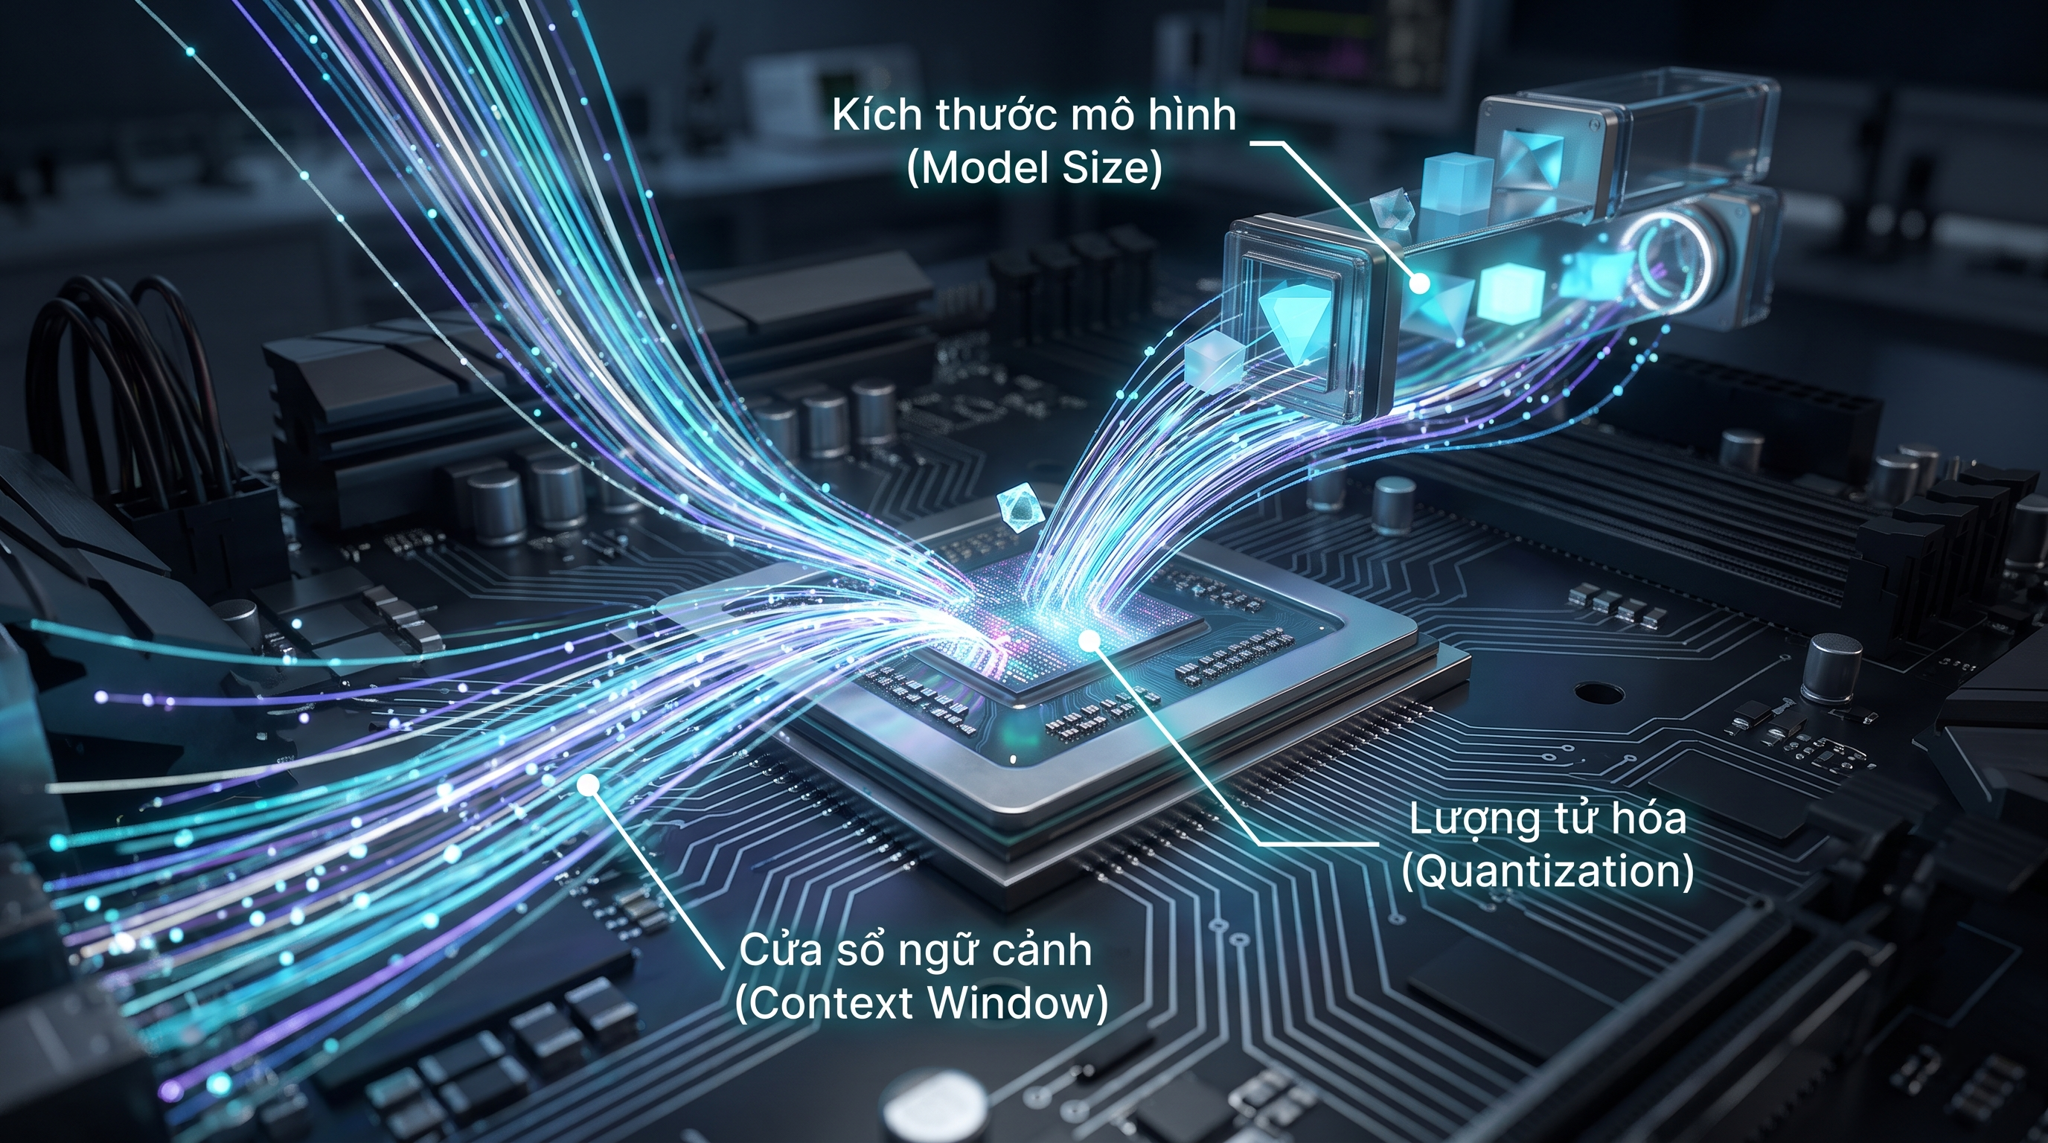
Khi bắt đầu tìm hiểu Local AI, bạn sẽ liên tục gặp ba khái niệm. Hãy hình dung chúng như ba đặc tính của một chiếc xe: dung tích động cơ, mức tiêu hao nhiên liệu đã tối ưu, và tầm nhìn của tài xế.
Model size, quantization và context trong Local AI
2.1. Kích thước mô hình (Model Size) — Dung tích động cơ
Kích thước mô hình được đo bằng số lượng tham số (parameters). Mỗi tham số là một con số toán học được tối ưu trong quá trình huấn luyện, giống như các "nơ-ron" nhân tạo. Các mô hình ngôn ngữ lớn (LLM) thường chứa hàng chục tỷ tham số.
Quy tắc đơn giản: càng nhiều tham số, mô hình càng có tiềm năng "thông minh" — nhưng cũng càng cần nhiều RAM hoặc VRAM để chạy.
2.2. Lượng tử hóa (Quantization) — Tối ưu mức tiêu hao
Lượng tử hóa (quantization) là kỹ thuật nén mô hình bằng cách giảm độ chính xác số học của các tham số. Hãy tưởng tượng bạn có một bức ảnh: ảnh RAW chi tiết nhất nhưng nặng nhất, ảnh JPEG đã nén nhẹ hơn nhiều nhưng vẫn đẹp, còn nén quá mức sẽ bị vỡ hạt.
Với LLM, quá trình này thường là chuyển từ số thực 16-bit (FP16) xuống số nguyên 4-bit hoặc 8-bit (INT4, INT8). Kết quả: mô hình nhẹ hơn, chạy nhanh hơn trên các máy có tài nguyên hạn chế. Đây là "chìa khóa" giúp doanh nghiệp tận dụng phần cứng sẵn có thay vì đầu tư máy chủ đắt đỏ.
2.3. Cửa sổ ngữ cảnh (Context Window) — Tầm nhìn của tài xế
Cửa sổ ngữ cảnh là giới hạn số lượng "token" (đơn vị ngôn ngữ — gần giống từ hoặc ký tự) mà mô hình có thể "nhìn thấy" và xử lý trong một lần trả lời.
Cửa sổ càng lớn, mô hình càng có thể xử lý được văn bản dài, như cả một cuốn sách hay toàn bộ tài liệu tham khảo. Nhưng đồng thời, nó cũng tiêu tốn nhiều bộ nhớ hơn và phản hồi chậm hơn do lượng tính toán bộ nhớ đệm KV (Key-Value cache) tăng vọt.
3. Mối quan hệ giữa ba yếu tố
Ba yếu tố này không tồn tại độc lập mà tương tác chặt chẽ với nhau:
Mô hình lớn + lượng tử hóa nhẹ: chất lượng tốt nhất nhưng cần nhiều RAM.
Mô hình lớn + lượng tử hóa sâu: chạy được trên máy yếu hơn nhưng có thể giảm chất lượng câu trả lời, thậm chí làm tăng nguy cơ "ảo giác" — mô hình tự bịa ra thông tin không có thật (confabulation).
Cửa sổ ngữ cảnh lớn: giúp mô hình tiếp nhận nhiều tài liệu tham khảo cùng lúc nhưng ngốn thêm bộ nhớ và tăng độ trễ phản hồi.
4. Những điều cần lưu ý khi bắt đầu
4.1. Chạy offline — nhưng cần mạng lúc đầu
Local AI có thể chạy ngoại tuyến sau khi đã tải mô hình về máy. Tuy nhiên, bạn vẫn cần kết nối mạng ban đầu để tải các tệp mô hình và môi trường thực thi từ danh mục trực tuyến về bộ nhớ đệm cục bộ. Sau bước này, mọi hoạt động suy luận mới diễn ra hoàn toàn offline.
4.2. Không có công thức "một cỡ vừa tất cả" cho RAM
Không tồn tại một con số RAM hoặc VRAM tối thiểu chung cho mọi mô hình. Mức tiêu thụ bộ nhớ thực tế phụ thuộc vào model cụ thể, mức lượng tử hóa, cửa sổ ngữ cảnh, và phần cứng bạn đang dùng. Đừng tin vào những tuyên bố kiểu "mô hình 7B luôn cần X GB RAM".
4.3. Tiêu hao điện năng là có thật
Quá trình suy luận AI tạo sinh tiêu tốn năng lượng đáng kể. Các tác vụ như tóm tắt văn bản tiêu hao năng lượng cao hơn rõ rệt so với phân loại văn bản đơn thuần. Lượng tử hóa giúp giảm bớt gánh nặng này, nhưng quá trình nén và tinh chỉnh ban đầu vẫn đóng góp vào dấu chân carbon.
5. Gợi ý cho người mới bắt đầu
Nếu bạn mới làm quen với Local AI, đây là lộ trình đơn giản:
Bắt đầu nhỏ: chọn mô hình lượng tử hóa 4-bit hoặc 8-bit — dung lượng vừa phải, chất lượng chấp nhận được cho hầu hết nhu cầu thông thường.
Dùng RAG để bù đắp: nếu mô hình nhỏ thiếu kiến thức chuyên sâu, bạn có thể áp dụng kỹ thuật Tạo sinh Tăng cường Truy xuất (RAG) để "neo" câu trả lời vào tài liệu nội bộ, thay vì dựa vào tri thức đông cứng trong mô hình.
Kiểm tra phần cứng: xác nhận máy bạn đang dùng đúng bộ tăng tốc (GPU, NPU) — nếu không, hệ thống sẽ tự lùi về CPU và chạy chậm hơn nhiều.
Kết luận
Hiểu đúng về kích thước mô hình, lượng tử hóa và cửa sổ ngữ cảnh là bước đầu tiên để làm chủ Local AI. Không có giải pháp "một cỡ vừa tất cả" — lựa chọn tối ưu phụ thuộc vào phần cứng bạn có, bài toán bạn cần giải quyết, và mức độ chấp nhận đánh đổi giữa chất lượng và tốc độ. Hãy bắt đầu với những mô hình nhẹ, thử nghiệm, và dần nâng cấp khi đã quen tay.
Xem thêm tại GearVN
