
AI chạy offline là gì? Khi nào Local AI thực sự không cần Internet
"AI chạy offline" không đồng nghĩa với việc thiết bị của bạn ngắt kết nối Internet vĩnh viễn. Thực chất, bạn chỉ cần mạng ở giai đoạn đầu để tải model và dependency; khi mọi thứ đã nằm trong cache, quá trình suy luận (inference) sẽ chạy hoàn toàn trên CPU, GPU hoặc NPU của máy. Cùng tìm hiểu chi tiết cơ chế hoạt động và cách triển khai mô hình này trong bài viết bên dưới!
1. AI chạy offline nghĩa là gì?
"AI chạy offline" là cách gọi tắt của việc triển khai inference mô hình AI hoàn toàn trên thiết bị cục bộ — tức mọi tác vụ suy luận (inference) được xử lý trên chính CPU, GPU hoặc NPU của máy bạn, không gửi request ra dịch vụ đám mây bên ngoài. Đây là một trong ba mô hình triển khai chính bên cạnh Cloud AI (chạy hoàn toàn trên dịch vụ từ xa) và Hybrid AI (phân chia tác vụ giữa local và cloud).
"AI chạy offline" là mô hình AI hoàn toàn trên thiết bị cục bộ
Tuy nhiên, "chạy offline" không có nghĩa là thiết bị của bạn không bao giờ cần kết nối Internet. Để hiểu rõ hơn, cần phân biệt hai giai đoạn trong vòng đời của một mô hình AI chạy local:
Giai đoạn tải và đăng ký mô hình: Hầu hết các local runtime cần mạng để tải model, execution provider hoặc dependency lần đầu. Sau khi artifact được lưu vào cache cục bộ, inference mới có thể chạy offline.
Giai đoạn inference: Khi model và backend đã sẵn sàng trên máy, bạn có thể ngắt mạng và inference vẫn hoạt động bình thường.
Ví dụ: Microsoft Foundry Local yêu cầu kết nối mạng để truy cập catalog và tải model/execution provider ban đầu, nhưng sau khi model được cache, inference có thể chạy hoàn toàn offline (theo tài liệu kiến trúc Foundry Local, Microsoft Learn, kiểm tra 2026-07).
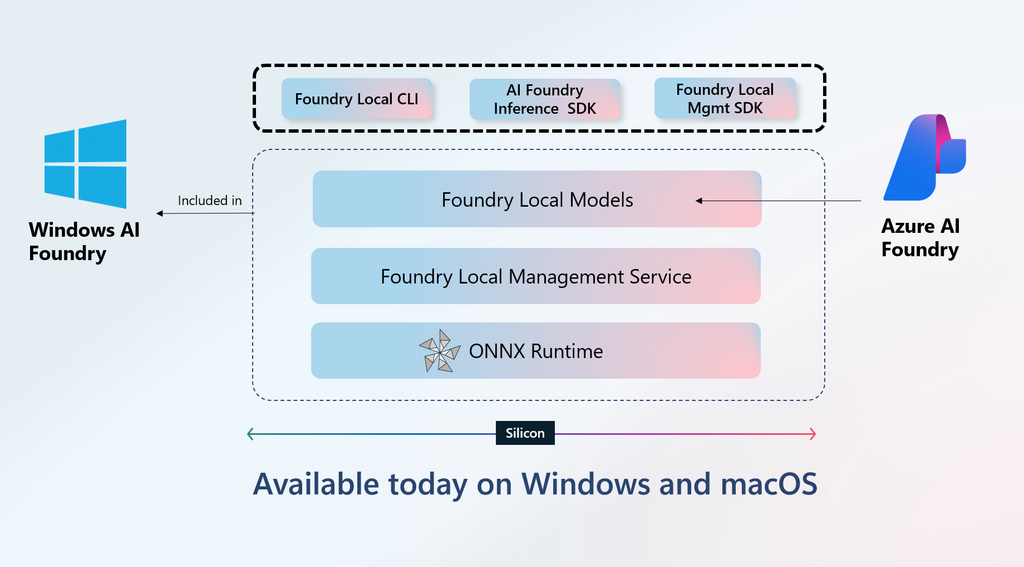
(Nguồn: Microsoft)
2. Các runtime phổ biến để chạy AI offline
Hiện có ba lựa chọn runtime chính cho nhu cầu chạy AI offline trên thiết bị cá nhân hoặc workstation:
2.1. Ollama
Ollama là runtime quản lý model LLM với local API server tích hợp sẵn. Sau khi tải model qua lệnh ollama pull, mọi request inference được xử lý trên localhost mà không cần kết nối mạng. Ollama công bố API tương thích OpenAI, cho phép tích hợp với các ứng dụng quen thuộc qua endpoint cục bộ (theo tài liệu chính thức Ollama, kiểm tra 2026-07).
2.2. LM Studio
LM Studio cung cấp giao diện desktop và local API server hỗ trợ cả OpenAI-compatible lẫn Anthropic-compatible API. Người dùng có thể chọn model từ catalog, tải về, và chạy inference localhost hoặc expose lên LAN nếu cần. Lưu ý: khi mở server ra LAN, threat model thay đổi — bạn cần thêm authentication và network policy (theo tài liệu LM Studio Developer Docs, kiểm tra 2026-07).
2.3. Microsoft Foundry Local
Foundry Local là giải pháp của Microsoft với lớp hardware abstraction tự động chọn execution provider qua ONNX Runtime trên CPU, GPU và NPU. Điểm khác biệt: Foundry Local cần mạng để tải model và provider từ catalog, nhưng sau khi cache, toàn bộ pipeline chạy offline. Khả năng tăng tốc phần cứng phụ thuộc vào nền tảng thiết bị cụ thể — không suy rộng tính năng của một vendor thành đặc điểm chung cho mọi phần mềm Local AI (theo tài liệu Microsoft Foundry Local architecture và Windows ML overview, kiểm tra 2026-07).
3. Không phải cứ "offline" là an toàn tuyệt đối
Một hiểu lầm phổ biến là "chạy AI offline = bảo mật tuyệt đối". Thực tế, theo NIST AI 600-1 (GAI Profile, xuất bản tháng 7/2024), hệ thống Generative AI vẫn mang các rủi ro cốt lõi ngay cả khi chạy local:
Prompt injection: Ứng dụng tích hợp LLM vẫn có thể bị direct hoặc indirect prompt injection, bất kể model chạy local hay cloud.
Rò rỉ dữ liệu: GAI có rủi ro rò rỉ hoặc sử dụng trái phép dữ liệu cá nhân và dữ liệu nhạy cảm từ chính dữ liệu huấn luyện hoặc input người dùng.
LAN exposure: Mở local API server ra mạng LAN thay đổi threat model — attacker trong cùng mạng có thể gửi request đến endpoint của bạn.
Đưa model về local giúp giảm rủi ro dữ liệu rời khỏi thiết bị, nhưng không tự động loại bỏ các rủi ro privacy và security.
4. Khi nào nên chọn AI chạy offline?
Dưới góc nhìn của technical builder, AI chạy offline phù hợp khi:
Latency là ưu tiên: Không phụ thuộc vào độ trễ mạng; inference nhanh hơn cho tác vụ real-time.
Data locality quan trọng: Dữ liệu nhạy cảm không được phép rời khỏi thiết bị hoặc mạng nội bộ.
Môi trường ngắt kết nối: Làm việc ở nơi không có Internet ổn định nhưng vẫn cần trợ lý AI (coding, phân loại, OCR).
Thử nghiệm và phát triển: Iterate nhanh trên model mà không tốn chi phí API hay lo rate limit.
Ngược lại, Cloud AI phù hợp hơn khi cần scale lớn, dịch vụ quản lý hoặc model quá nặng so với phần cứng local. Hybrid AI linh hoạt nhất nhưng tăng độ phức tạp về routing, consistency, identity và observability.
5. Checklist triển khai AI offline cho technical builder
Chọn runtime: Ollama (CLI-first, API OpenAI-compatible), LM Studio (GUI + API), hoặc Foundry Local (hệ sinh thái Microsoft, ONNX Runtime).
Pin version model: Xác định chính xác model, quantization level và backend trước khi test.
Kiểm tra API compatibility: "OpenAI-compatible" không đảm bảo mọi endpoint/field đều giống — test từng endpoint bạn cần.
Tải artifact qua mạng: Model, execution provider và dependency cần được tải ít nhất một lần.
Ngắt mạng và test: Xác minh inference hoạt động bình thường sau khi ngắt kết nối.
Cấu hình network policy: Nếu cần expose API ra LAN, thêm authentication, TLS và giới hạn IP.
Kiểm tra tài nguyên: Quantization có thể giảm memory usage và cải thiện inference speed trong điều kiện phù hợp, nhưng không có một cấu hình RAM/VRAM tối thiểu dùng cho mọi model. Sizing yêu cầu benchmark với model, runtime, context length và concurrency cụ thể.
6. Những câu hỏi thường gặp
6.1. AI chạy offline có cần Internet không?
Cần trong giai đoạn tải model, execution provider và cập nhật. Sau khi artifact được cache cục bộ, inference có thể chạy offline. Một số runtime như Foundry Local còn cần mạng để refresh catalog định kỳ.
6.2. Local AI có luôn riêng tư hơn cloud AI không?
Không. Mức độ riêng tư phụ thuộc vào endpoint exposure, telemetry/logging của runtime và policy vận hành. Đưa model về local giúp dữ liệu không rời khỏi thiết bị, nhưng LAN endpoint và log vẫn có thể tạo rủi ro nếu không được kiểm soát.
6.3. Có thể tích hợp app hiện có với AI chạy offline không?
Có, thông qua local API server của từng runtime. Ollama và LM Studio đều công bố API tương thích OpenAI; LM Studio hỗ trợ thêm Anthropic-compatible API. Cần kiểm tra chính xác endpoint và mức compatibility theo version.
6.4. Chọn Ollama, LM Studio hay Foundry Local?
Phụ thuộc OS, nhu cầu API, hệ sinh thái và workflow của bạn. Ollama thiên về CLI và tự động hóa; LM Studio có GUI thân thiện; Foundry Local phù hợp với hệ sinh thái Microsoft và ONNX Runtime. Không có lựa chọn "tốt nhất" tuyệt đối — cần đánh giá theo workload thực tế.
Nếu muốn đọc tiếp theo đúng nhu cầu triển khai, bạn có thể tham khảo bài so sánh Ollama và LM Studio và nội dung tổng quan về AI PC với CPU, GPU và NPU.
