
AWQ và GGUF: Đọc đúng số liệu tăng tốc trước khi chọn định dạng lượng tử hoá
AWQ vs GGUF là một so sánh dễ gây hiểu nhầm nếu chỉ nhìn vào vài dòng “nhanh hơn bao nhiêu lần”. AWQ là một phương pháp lượng tử hoá trọng số có nhận biết activation, còn GGUF là định dạng file phục vụ triển khai model theo hệ sinh thái ggml/llama.cpp. Vì vậy, khi chọn cho máy local AI, builder nên đọc đúng bản chất: AWQ nói nhiều hơn về cách nén và tăng tốc trọng số; GGUF nói nhiều hơn về cách đóng gói, load và vận hành model.
Mục lục bài viết1. AWQ và GGUF khác nhau ở tầng nào?2. Vì sao không nên kết luận AWQ luôn nhanh hơn GGUF?3. Đọc benchmark: Tokens/giây chưa phải toàn bộ câu chuyện4. Bảng đọc nhanh cho builder5. Runtime thay đổi nhanh, số liệu phải gắn phiên bản6. Chọn AWQ hay GGUF theo workload local AI7. Gợi ý quy trình benchmark tại nhà
1. AWQ và GGUF khác nhau ở tầng nào?
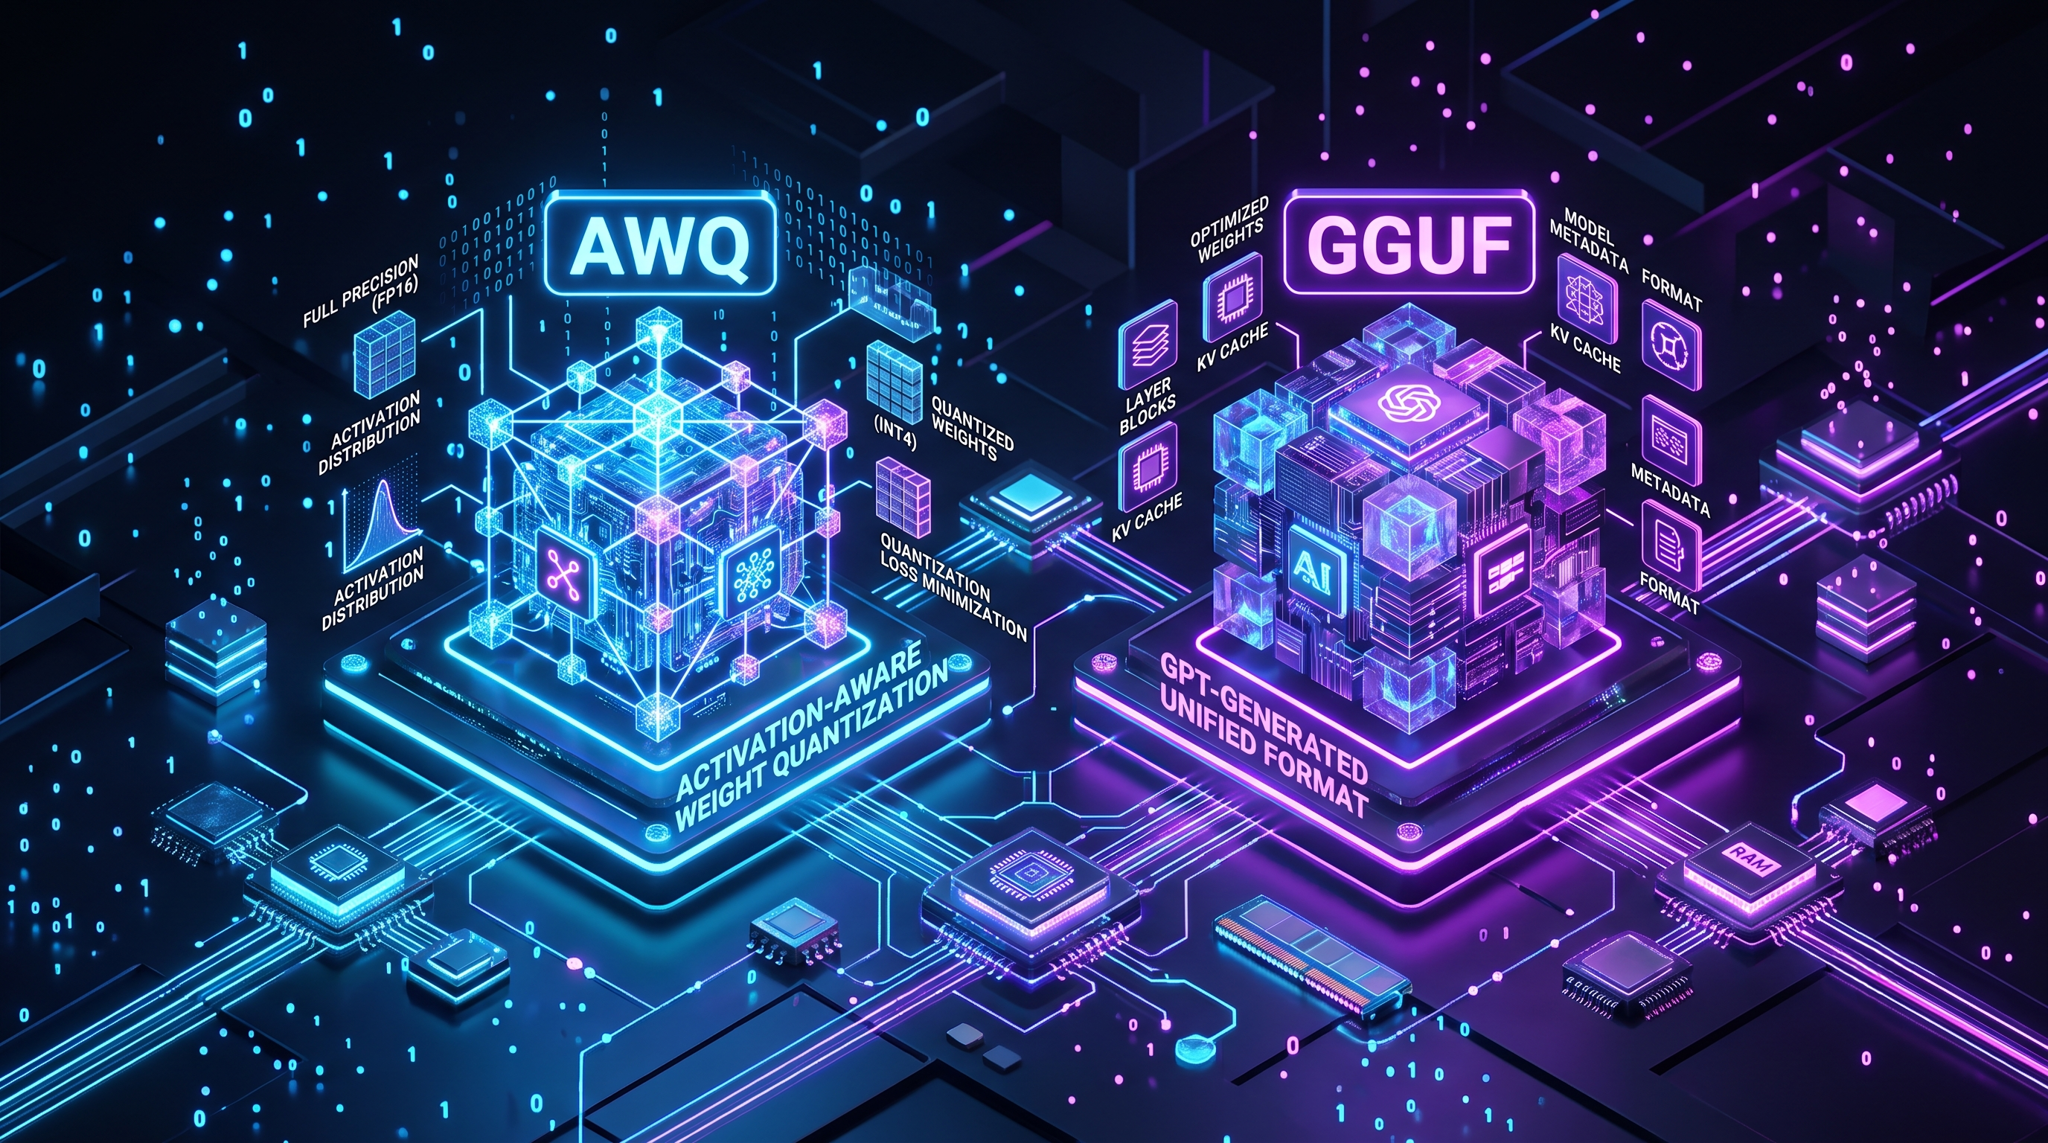
AWQ là phương pháp lượng tử hoá trọng số có nhận biết activation, hỗ trợ INT3/INT4 với activation 16-bit theo kiểu W4A16. Repo của MIT Han Lab công bố AWQ nhanh hơn FP16 khoảng 2,7 lần trên RTX 4090 và 2,9 lần trên Jetson Orin với LLaMA-3-8B; công trình này đạt Best Paper Award tại MLSys 2024.
Minh họa AWQ và GGUF
GGUF lại là một định dạng được thiết kế cho triển khai một file duy nhất. GGUF hỗ trợ nạp bằng mmap và tự chứa thông tin cần thiết để load model, bao gồm cả tokenizer. Với người dựng stack local AI, điểm mạnh thực tế của GGUF nằm ở tính đóng gói và khả năng vận hành thuận tiện trong các runtime tương thích.
GGUF cũng định nghĩa nhiều họ lượng tử hoá, từ legacy như F32, F16, Q4_0, Q5_0, Q8_0, đến K-series như Q2_K, Q3_K, Q4_K, Q5_K, Q6_K, Q8_K, nhóm IQ như IQ2_XXS, IQ3_XXS, IQ4_NL, cùng các định dạng BF16, MXFP4, TQ1_0 và TQ2_0. Nói cách khác, GGUF không phải chỉ là “một mức quant”; nó là container cho nhiều lựa chọn đánh đổi dung lượng và độ chính xác.
2. Vì sao không nên kết luận AWQ luôn nhanh hơn GGUF?
Điểm quan trọng: gói dữ liệu hiện có không chứng minh một phép so trực tiếp AWQ và GGUF trong cùng điều kiện. Con số AWQ nhanh hơn FP16 khoảng 2,7 lần trên RTX 4090 và 2,9 lần trên Jetson Orin là số liệu do chính repo AWQ công bố, đo với phần cứng và model của họ. Đây không phải là bảng benchmark độc lập giữa AWQ và GGUF.
Với builder kỹ thuật, câu hỏi đúng không phải là “AWQ hay GGUF nhanh hơn?”, mà là: bạn đang đo tầng nào, model nào, backend nào, phần cứng nào, batch/context nào và metric nào? Một kết quả decoding tốt không tự động đồng nghĩa với thời gian phản hồi đầu tiên tốt hơn; một file nhỏ hơn cũng không đảm bảo throughput cao hơn trong mọi runtime.
3. Đọc benchmark: Tokens/giây chưa phải toàn bộ câu chuyện
Trong llama.cpp, công cụ llama-bench báo kết quả theo tokens/giây, kèm trung bình và độ lệch chuẩn qua nhiều lần lặp, mặc định 5 lần. Tuy nhiên, công cụ này không tính thời gian tokenization và sampling vào phép đo. Vì vậy, nếu dùng số tokens/giây để dự đoán trải nghiệm chat thật, bạn cần nhớ rằng pipeline thực tế còn có những phần ngoài vùng đo.
llama-bench cũng tách hai chế độ đo khác bản chất: prompt processing, viết tắt là pp, mặc định 512 token; và text generation, viết tắt là tg, mặc định 128 token. Ngoài ra còn có chế độ kết hợp pg. Với workload RAG hoặc coding agent, prompt dài có thể làm pp quan trọng hơn; với chat sinh câu trả lời dài, tg lại dễ được chú ý hơn.
Ở cấp benchmark rộng hơn, MLPerf Client v1.6 phát hành ngày 06/04/2026 đo workload LLM chạy cục bộ trên PC qua các backend Windows ML, llama.cpp trên Windows và macOS, MLX với Metal, và llama.cpp với Metal. MLPerf Client báo cả tính đáp ứng lẫn thông lượng; trong đó time to first token, hay TTFT, là thời gian chờ trước token đầu tiên và giá trị thấp hơn là tốt hơn.
4. Bảng đọc nhanh cho builder
Tiêu chí | AWQ | GGUF |
Bản chất | Phương pháp lượng tử hoá trọng số có nhận biết activation | Định dạng file triển khai model một file |
Điểm cần đọc kỹ | Số tăng tốc thường gắn với model, phần cứng và kernel cụ thể | Mức quant nằm bên trong GGUF có nhiều họ khác nhau |
Ý nghĩa vận hành | Phù hợp khi pipeline hỗ trợ đúng kiểu W4A16 và backend tối ưu | Thuận tiện cho runtime tương thích, tự chứa tokenizer và metadata cần thiết |
Cách benchmark nên xem | So với FP16 trong cùng điều kiện, không suy rộng sang mọi định dạng | Đo pp, tg, TTFT và throughput theo đúng workload local |
5. Runtime thay đổi nhanh, số liệu phải gắn phiên bản
Hệ sinh thái local AI thay đổi theo từng bản phát hành, nên số liệu tối ưu không nên được tách khỏi ngày và version. Ví dụ, Ollama v0.32.4 ngày 25/07/2026 tối ưu decoding cho Qwen3 MoE với expert ở mức lượng tử hoá hỗn hợp, cải thiện khoảng 4–9%. Đây là một nhắc nhở tốt: đôi khi khác biệt tốc độ đến từ runtime và kernel decoding, không chỉ từ tên định dạng lượng tử hoá.
Trong tháng 8/2026, Ollama cũng có nhiều thay đổi liên quan hiệu năng và nền tảng. Ollama v0.32.6 ngày 04/08/2026 cải thiện hiệu năng GPU Apple cho Qwen3.5 bằng speculative decoding qua MTP head tự động, đồng thời chuẩn hoá định dạng streaming /v1/chat/completions khớp OpenAI. Ollama v0.32.10 ngày 12/08/2026, ở trạng thái pre-release, đổi mặc định repeat_penalty từ 1.1 xuống 1.0 cho model không khai báo tham số này và cải thiện prefill NVFP4 trên MLX khoảng 7–8% ở một số model.
Ở phía llama.cpp, bản b10369 ngày 12/08/2026 tích hợp Pocket-TTS cho sinh audio, với thời gian sinh mỗi frame giảm khoảng 80% trên CUDA và khoảng 50% trên CPU. Bản b10356 ngày 11/08/2026 nâng hỗ trợ ROCm từ 7.2.1 lên 7.14 và là bản production đầu tiên dùng hệ thống build TheRock. Những mốc này không trực tiếp trả lời AWQ hay GGUF nhanh hơn, nhưng cho thấy backend và phiên bản có thể làm thay đổi kết quả thực tế.
6. Chọn AWQ hay GGUF theo workload local AI
Nếu bạn đang tối ưu một pipeline đã hỗ trợ AWQ tốt, đặc biệt cần khai thác INT3/INT4 với activation 16-bit, AWQ là lựa chọn đáng kiểm thử. Nhưng hãy benchmark trên đúng model và GPU bạn dùng, thay vì mượn con số RTX 4090 hoặc Jetson Orin rồi áp vào cấu hình khác.
Nếu mục tiêu là triển khai gọn, dễ quản lý model, dễ load trong runtime tương thích và cần nhiều mức lượng tử hoá để thử nghiệm dung lượng, GGUF thường là hướng thực dụng. Lợi thế một file, hỗ trợ mmap và tự chứa tokenizer giúp quá trình vận hành local AI bớt rối, nhất là khi phải đổi model hoặc kiểm thử nhiều mức quant.
Với ứng dụng chat, coding assistant hoặc RAG cục bộ, hãy đo ít nhất ba nhóm số: prompt processing, text generation và TTFT. Tokens/giây cao ở tg rất hấp dẫn, nhưng nếu prompt dài làm pp chậm hoặc TTFT cao, trải nghiệm người dùng vẫn có thể kém.
7. Gợi ý quy trình benchmark tại nhà
- Giữ cố định model và prompt. Đừng so AWQ trên một model với GGUF trên model khác rồi kết luận về định dạng.
- Tách pp và tg. Workload đọc tài liệu dài, RAG hoặc agent thường chịu ảnh hưởng lớn từ prompt processing.
- Ghi rõ backend và version. llama.cpp, MLX, Ollama hay Windows ML có thể cho hành vi khác nhau theo bản phát hành.
- Nhìn độ lệch chuẩn. Kết quả nhiều lần lặp có trung bình và độ lệch chuẩn đáng tin hơn một lần chạy đơn lẻ.
Không bỏ qua TTFT. Với chatbot, cảm giác nhanh thường bắt đầu từ token đầu tiên, không chỉ tổng tokens/giây.
Kết luận: AWQ vs GGUF là bài toán đo đúng, không phải chọn theo khẩu hiệu
AWQ và GGUF phục vụ hai lớp khác nhau trong stack local AI. AWQ là phương pháp lượng tử hoá có số liệu tăng tốc đáng chú ý so với FP16 trong điều kiện công bố của tác giả. GGUF là định dạng triển khai một file, hỗ trợ nhiều họ lượng tử hoá và thuận tiện cho runtime tương thích.
Nếu bạn là technical builder, cách chọn an toàn nhất là dựng benchmark theo workload thật: đo pp, tg, TTFT, ghi rõ backend, version, phần cứng và mức quant. Khi đó, “AWQ vs GGUF” không còn là cuộc tranh luận chung chung, mà trở thành một quyết định kỹ thuật dựa trên số liệu đúng ngữ cảnh.
