
GGUF Q4_K_M: Đo mức lượng tử hoá bằng llama-bench cho đúng phương pháp
GGUF Q4_K_M là lựa chọn quen thuộc khi builder muốn chạy LLM cục bộ theo hướng tiết kiệm dung lượng, nhưng nếu chỉ mở model lên rồi cảm nhận “nhanh hay chậm” thì rất dễ kết luận sai. Cách đúng hơn là đo có kiểm soát bằng llama-bench, tách rõ tốc độ xử lý prompt, tốc độ sinh token và điều kiện chạy.
Bài này tập trung vào phương pháp: Dùng llama-bench để đọc đúng hiệu năng của một bản GGUF Q4_K_M, hiểu giới hạn của con số tokens/giây, và tránh biến kết quả benchmark thành một kết luận quá rộng về chất lượng model.
Mục lục bài viết1. GGUF Q4_K_M thực chất đang nằm trong bức tranh lượng tử hoá nào?2. Vì sao không nên đo Q4_K_M bằng cảm giác?3. Hai phép đo phải tách riêng: pp và tg4. Cách đọc tokens/giây và độ lệch chuẩn5. Đừng nhầm benchmark hiệu năng với benchmark chất lượng6. Gợi ý quy trình đo GGUF Q4_K_M7. Liên hệ với benchmark chuẩn hơn như MLPerf Client8. Q4_K_M trong workflow local AI thực tế9. Đừng suy diễn quá mức từ một mức lượng tử hoá10. Mẫu bảng kết quả nên có
1. GGUF Q4_K_M thực chất đang nằm trong bức tranh lượng tử hoá nào?
GGUF là định dạng được thiết kế cho triển khai model dưới dạng một file duy nhất, hỗ trợ nạp bằng mmap và tự chứa các thông tin cần thiết để load model, gồm cả tokenizer. Đây là lý do GGUF thường xuất hiện trong các workflow local AI: Builder có thể quản lý model như một artifact độc lập, dễ di chuyển và dễ thử nghiệm giữa các mức lượng tử hoá.
Trong đặc tả GGUF, các mức lượng tử hoá không chỉ có một nhóm duy nhất. GGUF định nghĩa nhóm legacy như F32, F16, Q4_0, Q4_1, Q5_0, Q5_1, Q8_0, Q8_1; nhóm K-series như Q2_K, Q3_K, Q4_K, Q5_K, Q6_K, Q8_K; nhóm IQ như IQ2_XXS, IQ3_XXS, IQ4_NL; cùng các định dạng khác như BF16, MXFP4, TQ1_0 và TQ2_0. Ý nghĩa thực tế là mỗi mức lượng tử hoá là một điểm đánh đổi giữa dung lượng và độ chính xác, không phải một nhãn “tốt” hoặc “dở” tuyệt đối.
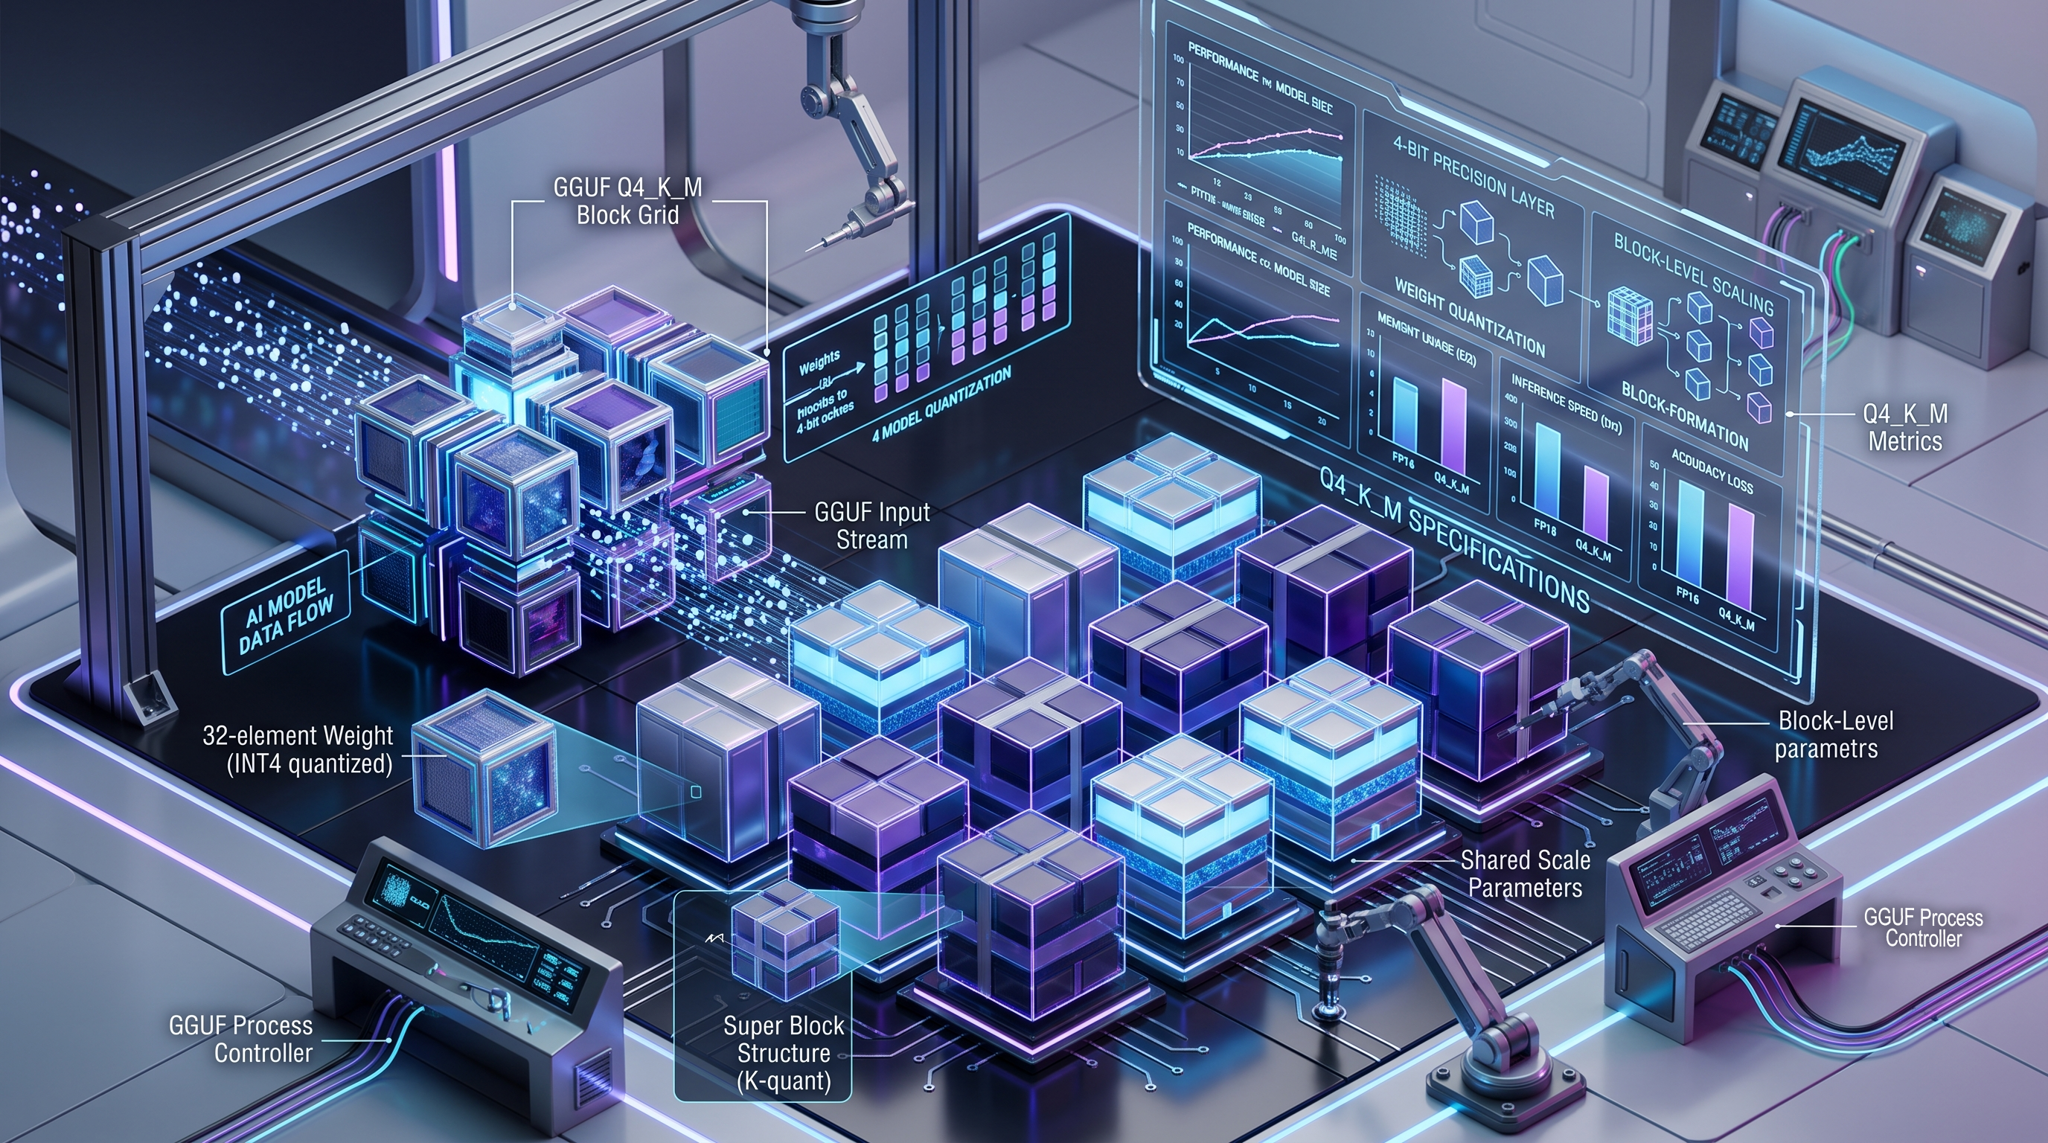
GGUF lại là một định dạng được thiết kế cho triển khai một file duy nhất
Vì vậy, khi nói đến GGUF Q4_K_M câu hỏi đúng không chỉ là “Model này chạy được không”, mà là: "Trong cùng model, cùng runtime, cùng máy và cùng tham số đo, mức này cho tốc độ như thế nào ở từng pha suy luận?"
2. Vì sao không nên đo Q4_K_M bằng cảm giác?
Một phiên chat local có nhiều thành phần: đọc prompt, xử lý context, sinh token, sampling, giao diện hiển thị, thậm chí cả tokenization trước khi đo. Nếu bạn chỉ nhìn tốc độ chữ chạy trên màn hình, kết quả sẽ trộn nhiều yếu tố vào nhau. Điều này đặc biệt nguy hiểm khi so sánh các mức lượng tử hoá, vì mức nhẹ hơn có thể nhanh hơn ở một pha nhưng không đồng nghĩa luôn đem lại trải nghiệm tốt hơn trong mọi workload.
llama-bench hữu ích ở chỗ nó báo kết quả theo tokens/giây, kèm trung bình và độ lệch chuẩn qua nhiều lần lặp; mặc định là 5 lần. Quan trọng hơn, công cụ này không tính thời gian tokenization và sampling vào phép đo. Nhờ vậy, builder đang nhìn vào phần lõi hiệu năng suy luận thay vì một con số bị nhiễu bởi quá nhiều lớp xung quanh.
3. Hai phép đo phải tách riêng: pp và tg
Điểm nhiều người mới benchmark hay bỏ qua là llama-bench tách hai chế độ đo khác bản chất: prompt processing và text generation. Prompt processing, ký hiệu pp, mặc định đo với 512 token. Text generation, ký hiệu tg, mặc định đo với 128 token. Ngoài ra còn có chế độ kết hợp pg.
Với workload hỏi đáp ngắn, coding assistant hoặc agent local, hai pha này có vai trò khác nhau. Prompt processing ảnh hưởng đến tốc độ “nuốt” phần ngữ cảnh ban đầu: system prompt, lịch sử chat, tài liệu truy hồi, đoạn code được đưa vào. Text generation ảnh hưởng đến tốc độ model sinh câu trả lời sau khi đã bắt đầu trả token.
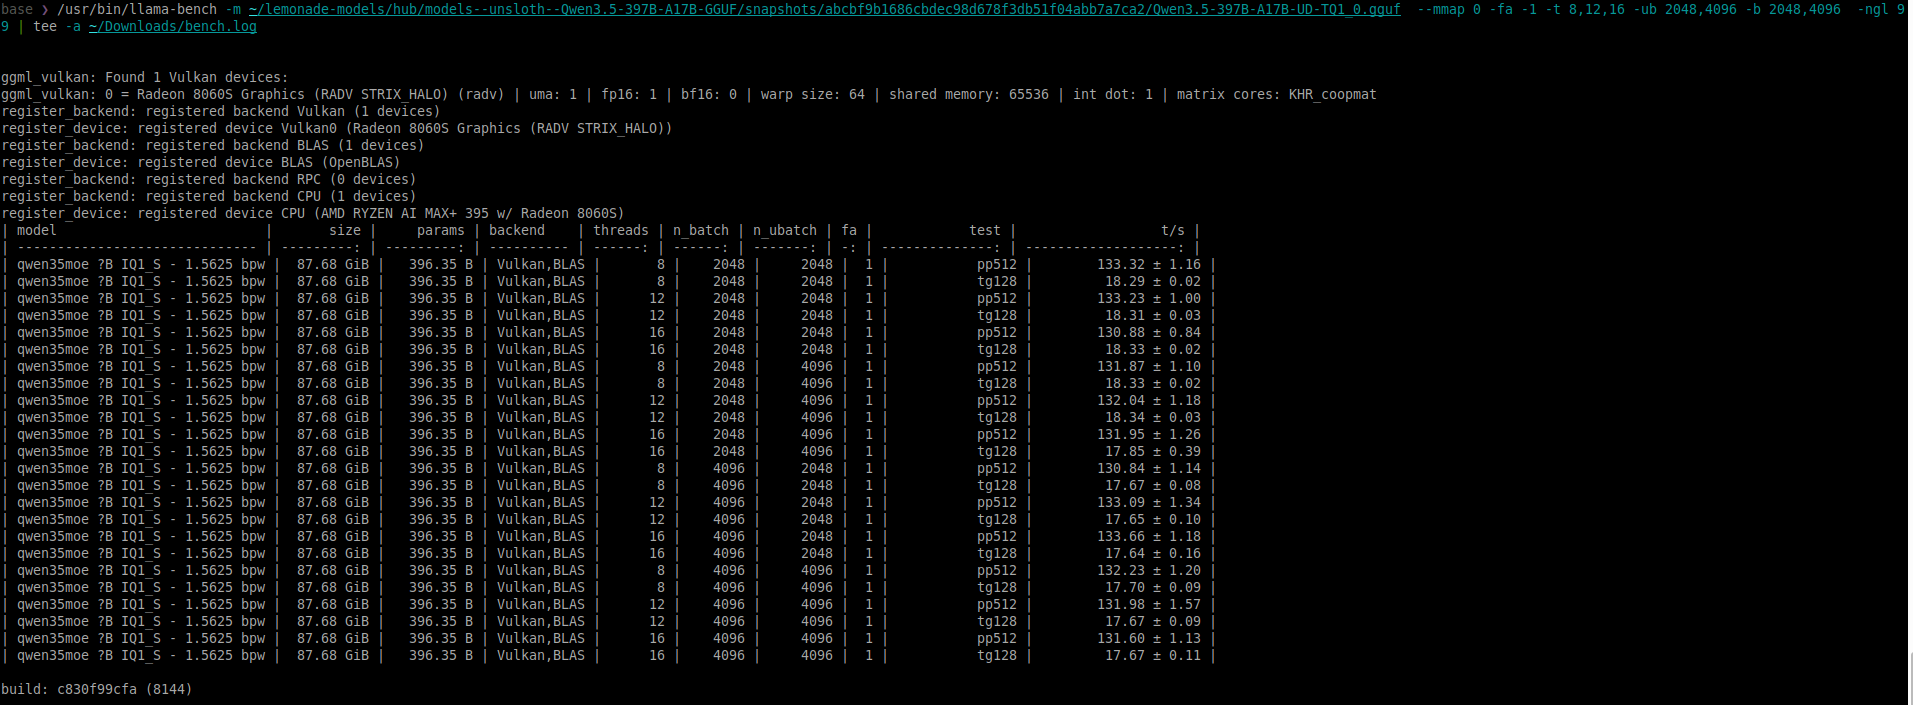
Kết quả benchmark của Qwen3.5-397B-A17B-UD-TQ1 (Nguồn: st.)
Nếu chỉ lấy một dòng tokens/giây rồi kết luận Q4_K_M “nhanh hơn” hoặc “chậm hơn”, bạn có thể đang bỏ qua việc nó nhanh ở pp nhưng chưa chắc nổi bật ở tg, hoặc ngược lại. Một bảng đo nghiêm túc nên luôn ghi ít nhất hai cột: pp tokens/s và tg tokens/s.
4. Cách đọc tokens/giây và độ lệch chuẩn
Tokens/giây là đơn vị thuận tiện để so sánh trong cùng điều kiện, nhưng nó không phải toàn bộ trải nghiệm người dùng. Với llama-bench, hãy đọc cả giá trị trung bình lẫn độ lệch chuẩn. Trung bình cho biết mức hiệu năng đại diện qua nhiều lần chạy; độ lệch chuẩn giúp bạn biết kết quả có ổn định hay dao động mạnh.
Nếu hai cấu hình chỉ chênh nhau nhẹ nhưng độ lệch chuẩn lớn, đừng vội tuyên bố một bên thắng tuyệt đối. Với builder kỹ tính, kết luận nên có dạng: “Trong điều kiện này, Q4_K_M đạt mức tg cao hơn cấu hình còn lại, nhưng độ dao động vẫn cần theo dõi thêm”, thay vì biến một lần chạy thành chân lý.
5. Đừng nhầm benchmark hiệu năng với benchmark chất lượng
llama-bench giúp đo tốc độ suy luận, không trả lời câu hỏi model suy luận hay hơn hay kém hơn sau lượng tử hoá. Với GGUF, đặc tả chỉ cho biết các họ lượng tử hoá cho phép đánh đổi dung lượng lấy độ chính xác; bản thân phép đo tokens/giây không chứng minh chất lượng trả lời, độ chính xác toán học, khả năng code hay mức tuân thủ instruction.
Do đó, quy trình tốt là tách hai vòng đánh giá. Vòng một dùng llama-bench để lọc các mức lượng tử hoá có hiệu năng phù hợp. Vòng hai dùng bộ prompt thực tế của bạn để kiểm tra chất lượng câu trả lời. Với GearVN, đây là cách nhìn thực dụng hơn cho người build máy local AI: benchmark để hiểu máy, test prompt để hiểu model.
6. Gợi ý quy trình đo GGUF Q4_K_M
6.1. Cố định model và runtime
Chỉ thay một biến tại một thời điểm. Nếu đang so sánh Q4_K_M với một mức lượng tử hoá khác, hãy giữ nguyên model gốc, runtime, backend, tham số context và điều kiện máy. Nếu vừa đổi model, vừa đổi runtime, vừa đổi mức lượng tử hoá, bạn sẽ không biết yếu tố nào tạo ra khác biệt.
6.2. Chạy riêng pp và tg
Hãy ghi riêng kết quả prompt processing và text generation. Với llama-bench, pp mặc định 512 token còn tg mặc định 128 token, nên hai con số này đại diện cho hai pha khác nhau. Khi workload của bạn có context dài, pp trở nên rất quan trọng. Khi workload là chat liên tục và sinh câu trả lời dài, tg sẽ dễ được cảm nhận hơn.
6.3. Nhìn trung bình và độ lệch chuẩn
Không nên chỉ chụp một kết quả đẹp nhất. llama-bench mặc định chạy nhiều lần và báo trung bình kèm độ lệch chuẩn, vì vậy hãy dùng chính hai thông tin này để đánh giá độ ổn định. Một cấu hình có tốc độ trung bình cao nhưng dao động lớn có thể chưa phải lựa chọn dễ chịu nhất cho máy dùng hằng ngày.
6.4. Ghi rõ điều kiện đo
Benchmark không có ngữ cảnh thì gần như không tái lập được. Bảng kết quả nên ghi model, mức lượng tử hoá, backend, chế độ đo pp hoặc tg, số lần lặp, và môi trường chạy. Nếu sau này bạn cập nhật runtime hoặc driver, hãy đo lại thay vì dùng số cũ để kết luận.
7. Liên hệ với benchmark chuẩn hơn như MLPerf Client
Ở quy mô chuẩn hoá hơn, MLPerf Client v1.6 phát hành ngày 06/04/2026 đo workload LLM chạy cục bộ trên PC qua nhiều backend, gồm Windows ML, llama.cpp trên Windows và macOS, MLX với Metal, và llama.cpp với Metal. Điểm đáng chú ý là MLPerf Client không chỉ quan tâm thông lượng, mà còn báo tính đáp ứng.
Một chỉ số quan trọng trong nhóm này là time to first token, tức thời gian chờ trước token đầu tiên; giá trị thấp hơn là tốt hơn. Điều này nhắc builder rằng trải nghiệm local AI không chỉ là “mỗi giây sinh bao nhiêu token”, mà còn là người dùng phải chờ bao lâu trước khi thấy phản hồi đầu tiên.
llama-bench và MLPerf Client không thay thế hoàn toàn cho nhau. llama-bench gọn, hữu ích để soi nhanh các biến như mức lượng tử hoá trong hệ sinh thái llama.cpp. MLPerf Client cho góc nhìn benchmark client rộng hơn, có cả tính đáp ứng và thông lượng trên nhiều backend. Nếu bạn đang build nghiêm túc, hãy hiểu mục tiêu của từng công cụ trước khi so kết quả.
8. Q4_K_M trong workflow local AI thực tế
Một model GGUF Q4_K_M thường không chạy một mình. Trong stack local AI, nó có thể được phục vụ qua runtime cục bộ, dùng cho chat, embedding, tool calling hoặc coding assistant. Chẳng hạn, Ollama phục vụ REST API cục bộ mặc định tại localhost cổng 11434, với các endpoint generate, chat và embed.
Với endpoint chat, Ollama hỗ trợ tool calling qua tham số tools chứa định nghĩa hàm; model có thể sinh tool call có cấu trúc và kết quả được đưa lại vào lịch sử hội thoại. Với endpoint embed, hệ thống có thể sinh embedding từ một hoặc nhiều đoạn văn bản để đảm nhiệm phần truy hồi trong một stack RAG chạy cục bộ.
Điều này ảnh hưởng trực tiếp đến cách benchmark. Nếu use case của bạn là RAG local, prompt có thể dài vì phải nhét thêm đoạn truy hồi; pp sẽ quan trọng. Nếu use case là trợ lý viết code hoặc agent chạy lâu, tốc độ tg và độ ổn định qua nhiều lượt lại đáng chú ý hơn. Benchmark đúng phải đi theo workload thật, không chỉ theo một con số tổng quát.
9. Đừng suy diễn quá mức từ một mức lượng tử hoá
Cùng là tối ưu suy luận, nhưng các phương pháp có bản chất khác nhau. AWQ là phương pháp lượng tử hoá trọng số có nhận biết activation, hỗ trợ INT3/INT4 với activation 16-bit theo kiểu W4A16; repo của nhóm MIT Han Lab công bố mức nhanh hơn FP16 khoảng 2,7 lần trên RTX 4090 và 2,9 lần trên Jetson Orin với LLaMA-3-8B, đồng thời công trình đạt Best Paper Award tại MLSys 2024.
Tuy nhiên, không nên lấy số liệu AWQ đó để suy ra GGUF Q4_K_M sẽ nhanh tương tự trên máy của bạn. Đây là các kết quả từ phương pháp, phần cứng và model cụ thể. Với GGUF Q4_K_M, cách an toàn vẫn là đo trực tiếp trên chính cấu hình bạn định dùng.
10. Mẫu bảng kết quả nên có
| Biến đo | Nên ghi gì | Vì sao quan trọng? |
| Model | Tên model và bản GGUF | Tránh nhầm giữa các model khác nhau |
| Lượng tử hoá | Q4_K_M hoặc mức đang so sánh | Xác định đúng biến chính của bài test |
| Chế độ | pp, tg hoặc pg | Tách prompt processing khỏi text generation |
| Tokens/giây | Trung bình qua nhiều lần lặp | Đọc thông lượng thay vì cảm giác |
| Độ lệch chuẩn | Giá trị đi kèm trung bình | Đánh giá độ ổn định của kết quả |
| Môi trường | Backend, hệ điều hành, phần cứng, phiên bản runtime | Giúp tái lập và so sánh công bằng hơn |
Kết luận: Đo Q4_K_M đúng là đo theo pha, không đo theo cảm giác
Với GGUF Q4_K_M, benchmark có ích nhất khi bạn dùng nó để trả lời câu hỏi cụ thể: mức lượng tử hoá này xử lý prompt nhanh ra sao, sinh token nhanh ra sao, kết quả có ổn định không, và có phù hợp workload local AI của mình không. llama-bench là công cụ phù hợp cho bước này vì nó tách pp và tg, báo tokens/giây, trung bình và độ lệch chuẩn qua nhiều lần lặp, đồng thời không tính tokenization và sampling vào phép đo.
Đừng dùng một con số tokens/giây để kết luận toàn bộ giá trị của model. Hãy dùng benchmark để chọn ứng viên, rồi dùng bộ prompt thực tế để kiểm tra chất lượng. Đó là cách đo Q4_K_M thực tế hơn cho technical builder: rõ biến, rõ pha, rõ giới hạn và dễ lặp lại khi bạn nâng cấp runtime hoặc phần cứng.
