
RAG là gì? Cách Retrieval-Augmented Generation hoạt động
1. RAG là gì?
Retrieval-Augmented Generation (RAG) là kiến trúc kết hợp mô hình ngôn ngữ lớn (LLM) với nguồn dữ liệu bên ngoài qua ba bước cốt lõi: truy xuất (retrieve), bổ sung ngữ cảnh (augment) và sinh đáp án (generate). Thay vì chỉ dựa vào parametric memory – kiến thức đã học trong quá trình huấn luyện và dễ lạc hậu theo thời gian – RAG cho phép model tra cứu tài liệu thực tế ngay tại thời điểm truy vấn, đưa thông tin đó vào prompt làm grounding context rồi tạo câu trả lời có căn cứ. Kiến trúc này được Lewis et al. giới thiệu năm 2020 và hiện là nền tảng cho hầu hết hệ thống hỏi đáp trên tài liệu doanh nghiệp, chatbot nội bộ và trợ lý AI có khả năng dẫn nguồn.
2. Cách RAG hoạt động: pipeline từ câu hỏi đến câu trả lời
Bước 1 – Truy xuất (Retrieve): Câu hỏi người dùng được chuyển thành truy vấn, tìm trong kho tài liệu đã lập index để lấy các đoạn văn bản (chunk) liên quan nhất. Cơ chế tìm kiếm có thể là từ khóa (lexical), vector embedding (semantic) hoặc hybrid – kết hợp cả hai để tận dụng ưu điểm của từng phương pháp. Không có phương pháp nào luôn vượt trội: lexical bắt từ khóa chính xác tốt hơn, vector hiểu ngữ nghĩa tốt hơn, và hybrid thường cho kết quả cân bằng nhất trên đa dạng loại câu hỏi.
Bước 2 – Bổ sung ngữ cảnh (Augment): Các đoạn tài liệu retrieved được chèn vào prompt cùng instruction. Đây là bước quyết định: nếu truy xuất sai hoặc thiếu, câu trả lời sẽ lệch dù model mạnh đến đâu. Ngược lại, context đúng và đầy đủ giúp model tạo câu trả lời bám sát tài liệu gốc. Với agentic retrieval, hệ thống có thể phân rã câu hỏi phức tạp thành nhiều subquery, truy xuất từng phần rồi tổng hợp kết quả – điều mà một AI Agent thực hiện khi cần xử lý truy vấn nhiều bước.
Bước 3 – Sinh đáp án (Generate): Model tạo câu trả lời cuối cùng từ instruction và context đã cung cấp. Khác với fine-tuning – vốn thay đổi trọng số model để điều chỉnh hành vi và văn phong – RAG giữ nguyên model và chỉ thay đổi dữ liệu đầu vào, giúp cập nhật kiến thức nhanh hơn nhiều khi tài liệu thay đổi.
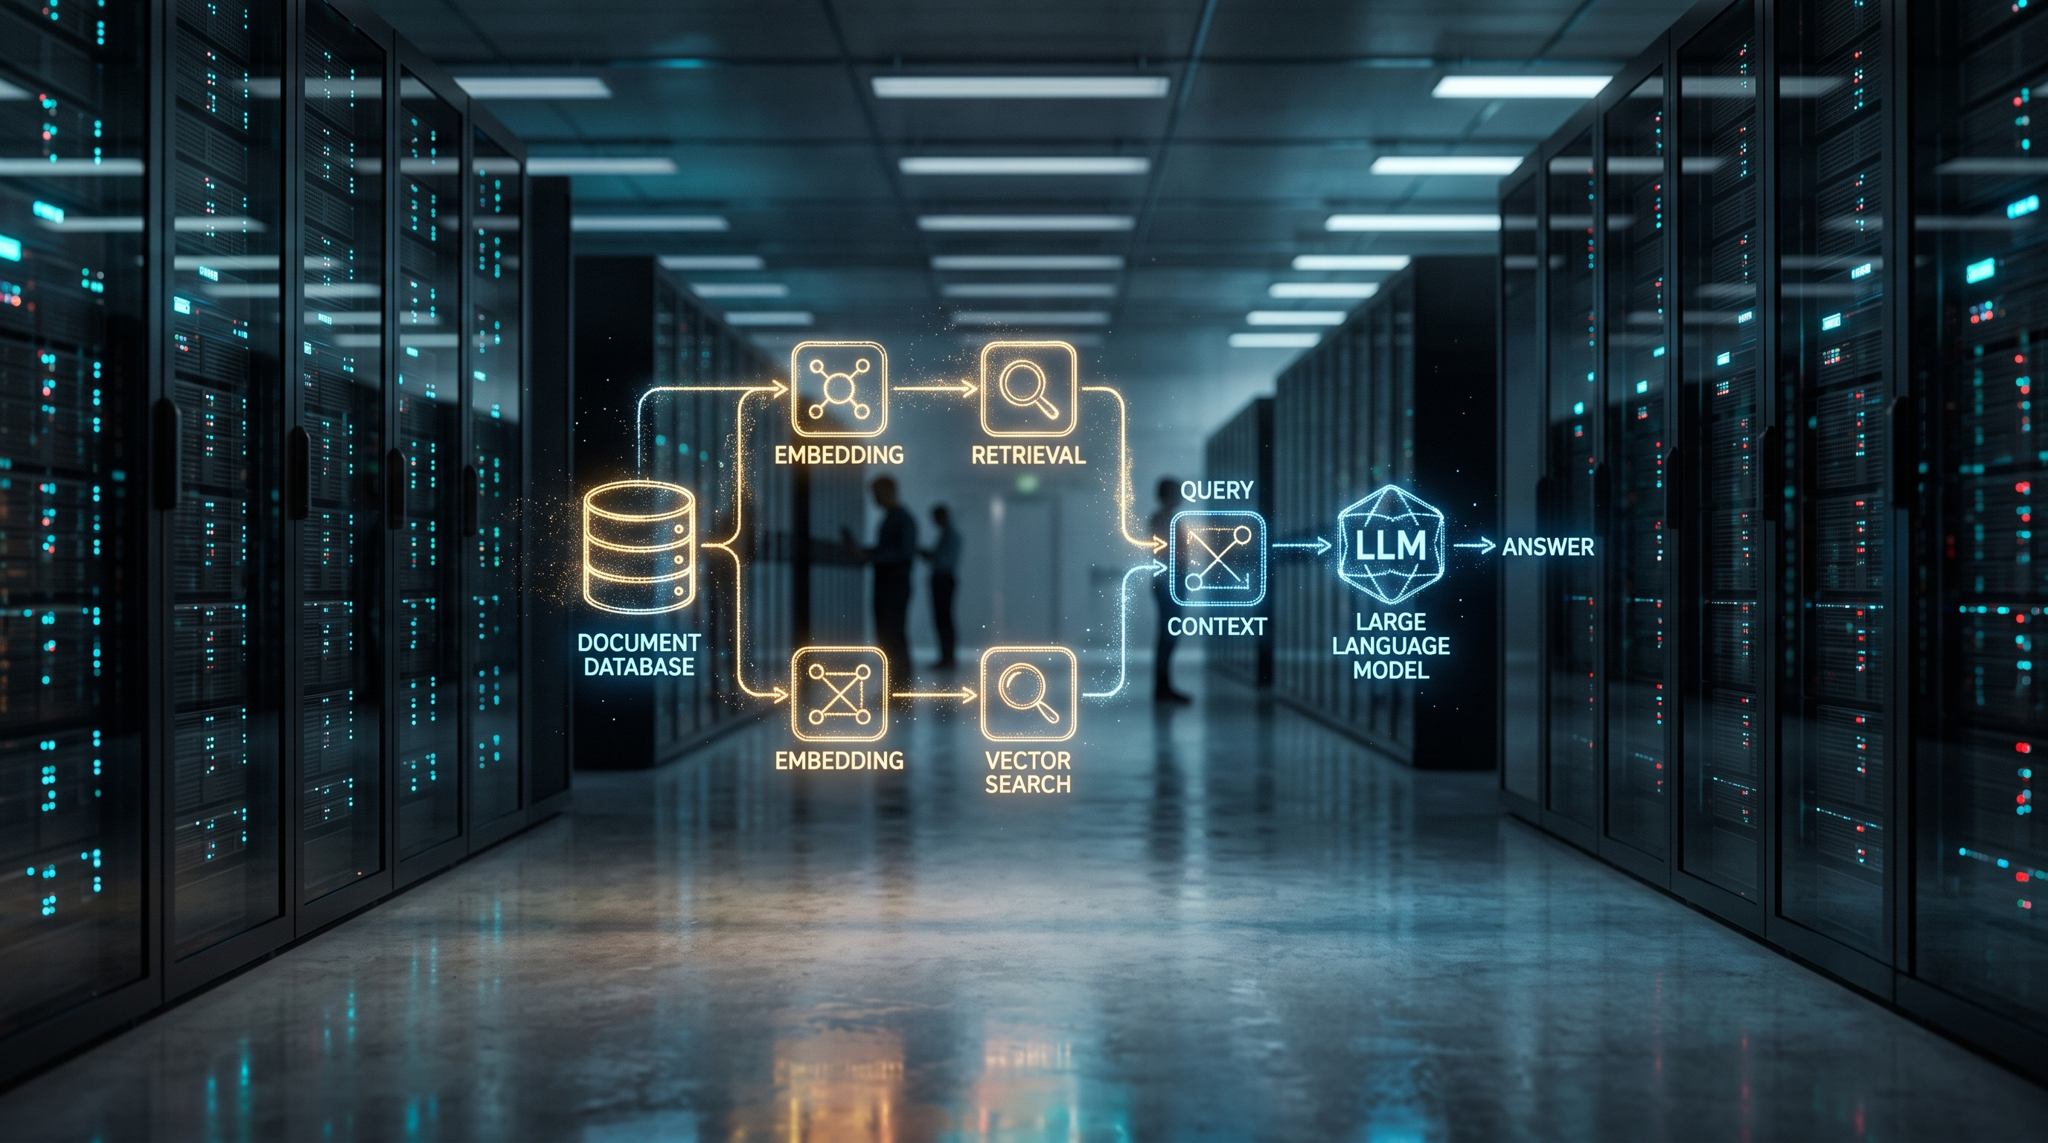
Cách hoạt động của RAG
3. Pipeline ingest: chuẩn bị tài liệu trước khi có query
Để retrieval hiệu quả, tài liệu phải trải qua ingest kỹ lưỡng từ trước:
Chunking: Tài liệu được chia thành các đoạn nhỏ (chunk) phù hợp với token limit của model và cấu trúc văn bản. Không tồn tại một kích thước chunk tối ưu cho mọi corpus – chunk quá nhỏ mất ngữ cảnh liên kết giữa các đoạn, chunk quá lớn gây nhiễu và lãng phí context window. Một số pipeline sử dụng overlap giữa các chunk để giảm mất thông tin ở ranh giới, nhưng overlap chỉ nên áp dụng khi cấu trúc tài liệu thực sự đòi hỏi. Tham số chunking cần được benchmark trên chính tập dữ liệu thật của ứng dụng, không sao chép mặc định từ vendor.
Indexing: Mỗi chunk được gắn metadata (nguồn, loại tài liệu, ACL) rồi chuyển thành vector embedding. Hệ thống xây dựng đồng thời text index cho tìm kiếm từ khóa và vector index cho tìm kiếm ngữ nghĩa. Metadata đóng vai trò filter và access control – nếu thiếu ACL ở tầng retrieval, dữ liệu nhạy cảm có thể bị lộ cho người không được phép truy cập.
Retrieval & ranking: Khi có query, hệ thống sinh danh sách candidate qua keyword, vector hoặc hybrid search. Sau đó filter và reranker sắp xếp lại theo độ liên quan trước khi context được đưa vào generation. Một điểm cần lưu ý: điểm similarity cao không đồng nghĩa đoạn văn bản đó trả lời đúng câu hỏi – retrieval và chất lượng câu trả lời cuối cùng phải được đánh giá tách biệt.
4. Đánh giá chất lượng RAG
Đánh giá hệ thống RAG cần tách thành hai tầng riêng biệt. Tầng retrieval đo bằng recall, NDCG hoặc fidelity trên tập query có ground truth – tức tập câu hỏi đã biết trước document/locator nào là đúng. Tầng generation đánh giá qua groundedness (mức độ gắn kết giữa câu trả lời và nguồn retrieved), relevance (độ liên quan đến câu hỏi) và completeness (mức độ đầy đủ của thông tin). Các bộ evaluator như Microsoft Foundry RAG evaluators cung cấp sẵn các metric này, nhưng threshold cụ thể phải được hiệu chỉnh trên từng ứng dụng và mức độ rủi ro chấp nhận được – không có ngưỡng điểm chung cho mọi hệ thống.
5. Giới hạn và rủi ro
Hallucination không biến mất: Grounding qua RAG giúp giảm đáng kể hallucination so với model chỉ dùng parametric memory, nhưng không loại bỏ hoàn toàn. Model vẫn có thể suy rộng ngoài context hoặc diễn giải sai nếu instruction không đủ rõ ràng. RAG cung cấp nguồn tham chiếu, không đảm bảo mọi câu trả lời đều chính xác.
Prompt injection: Tài liệu được retrieve phải được xử lý như dữ liệu không tin cậy. Nội dung độc hại trong tài liệu có thể trở thành indirect prompt injection – không có kỹ thuật đơn lẻ nào ngăn chặn hoàn toàn rủi ro này. Giải pháp là phòng vệ nhiều lớp: lọc input, giới hạn quyền tool, kiểm tra output và giám sát liên tục.
Chi phí và độ trễ: Mỗi query RAG tốn thêm token cho context retrieved, đồng thời tăng latency do bước retrieval và reranking. Với corpus lớn, chi phí này có thể đáng kể và cần được cân nhắc khi thiết kế kiến trúc.
6. RAG và fine-tuning: hai công cụ bổ trợ
RAG phù hợp khi kiến thức thay đổi thường xuyên và cần truy xuất nguồn chính xác – cập nhật index nhanh và rẻ hơn nhiều so với huấn luyện lại model. Fine-tuning phù hợp khi cần điều chỉnh hành vi, văn phong hoặc định dạng đầu ra ổn định. Trong thực tế, hai phương pháp không loại trừ nhau mà có thể kết hợp: fine-tune model để tuân thủ văn phong thương hiệu, rồi dùng RAG để cung cấp kiến thức cập nhật theo thời gian thực.
Để hiểu rõ hơn về cách chọn giữa hai phương pháp, bạn có thể tham khảo bài so sánh chi tiết RAG và fine-tuning.
